1. 概述
RCNN(Region with CNN features)[1] 算法是在经典论文《Rich feature hierarchies for Accurate Object Detection and Segmentation》中被提出,改论文发表在 2014 年 CVPR 的中。该论文是目标检测领域的一个里程碑,其重要的贡献是首次提出并使用卷积神经网络(Convolutional Neural Networks, CNNs)处理目标检测(Object Detetion)的问题。
2. 算法思想
2.1. RCNN算法流程
RCNN算法的流程图如下所示:
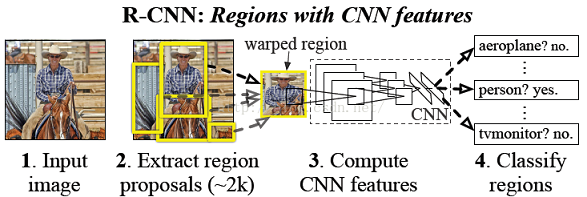
从图中可以看出,RCNN主要包括三个部分:
- 区域提名(Region Proposal):使用到了 Selective Search[2] 的方法,通过 Selective Search 产生约 2000 个目标可能出现的位置。在参考[3]中分别给出了 C++ 和 Python 的实现;
- 特征计算:特征计算阶段使用 CNN 算法,论文中使用 AlexNet 卷积神经网络,首先裁剪出上述 2000 个目标可能出现的位置的图像,并将其 reshape 成 ,最后通过 AlexNet 进行特征计算,得到 4096 维的特征向量;
- 分类算法:分类阶段是单独训练了 SVM 的分类器,对每一个类别训练一个二分类的分类器(yes/no)。
针对于候选区域的 reshape 过程,在参考[4]中做了详细的分析,如下图所示:
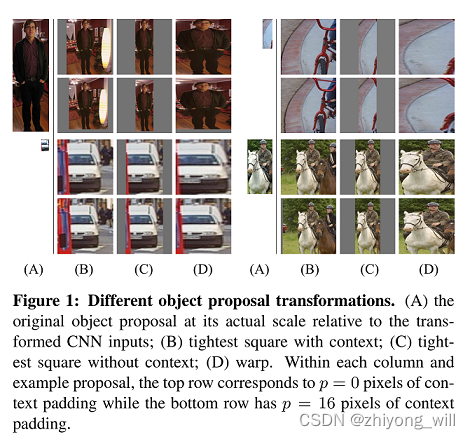
分析了三种的reshape方法,分别为:
- tightest square with context
- tightest square without context
- warp
2.2. 几个重要的概念
2.2.1. 交并比 IoU
IoU(Intersection-over-Union),即交并比,是目标检测中使用到的一个重要概念,是一种测量在特定数据集中检测相应物体准确度的一个标准。IoU 表示的是预测的候选框(candidate bounding box)与原标记框(ground truth bounding box)的交叠率(或者重叠度),也就是它们的交集与并集的比值。相关度越高该值。最理想情况是完全重叠,即比值为 1,如下图所示:
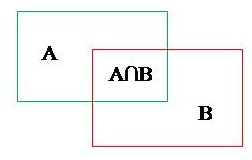
那么,IoU 的计算公式为:
2.2.2. 边框回归 Bounding Box Regression
在 RCNN 中,使用边框回归的目的是提高检测位置的准确性,简单来说就是让网络“修正”一个初始的猜测。那么,Bounding Box Regression 具体如何做呢?在参考[2]中给出了 Bounding Box Regression 的具体做法:假设数据集中有 个训练数据 ,其中 表示的是预测的边框,且 , 和 表示的是边框中心点的坐标, 和 表示的是边框的宽高。 表示的是真实的边框,其结构与 一致。我们的目标是寻找到一个映射 ,使得 ,同时 。
在 RCNN 中,边框回归是利用平移变换和尺度变换实现的。其中,平移变换为:
尺度变换为:
其中, 可以建模成特征(在 RCNN 中为 ,可以表示为 )的线性函数,即:,我们需要学习到参数 ,可通过对求解如下的最小化问题,得到对应的解:
其中,目标 可以由上述的两个变换得到:
2.2.3. 非极大抑制 NMS
非极大抑制 NMS(non maximum suppression),从其名称就可以看出,NMS 想要做到的是找到局部的极大值,抑制非极大值,主要用于在图像检测中剔除掉检测出来的冗余的 bbox。对于目标检测算法,最终我们会得到一系列的 bbox 以及对应的分类 score,NMS所做的工作就是将同一个类别下的 bbox 按照分类 score 以及 IoU 阈值做筛选,剔除掉冗余的 bbox,NMS的具体过程为:
- 在算法得到一系列 bbox 后,按照类别划分;
- 对于每一个分类,根据分类 score 对该类别下所有的 bbox 做降序排列,最终得到一个排好序的列表 list_i;
- 从列表 list_i 中取出最大 score 的 bbox_x,并将其与 list_i 中所有其他的 bbox_y 计算 IoU,若 IoU 大于某个阈值 T,则剔除 bbox_y,最终保留 bbox_x;
- 从剩余的 list_i 中重复上述的选择操作,直到 list_i 中的 bbox 都完成筛选;
- 对其余的类别的列表重复上述两步的操作。
2.3. RCNN 模型的训练
在模型训练之前,首先需要的是训练数据集,文章中使用的是 VOC 数据集,数据集中包含了 20 个类别的物体。RCNN 模型的训练需要分为几个部分单独计算,按照上述流程,分为三个部分:
- Region Proposal:对于训练集中的所有图像,使用 selective search 对每张图像提取出约 2000 个 region proposal,将提取出的 region proposal 保存在本地。
- AlexNet 的特征计算:通常,CNN 模型都会使用到预训练模型,同样,这里使用的 AlexNet 模型也是在 ILSVRC 2012 上预训练的模型。针对此处的训练数据集,需要对模型 Fine-tuning。针对 Fine-tuning 过程中使用到的数据集,对于一个 region proposal,如果其和图像上的所有 ground truth 中交并比 IoU 大于等于 0.5,则该 region proposal 作为这个 ground truth 类别的正样本,否则作为负样本,此外。ground truth 也作为正样本。因为 VOC 一共包含 20 个类别,另外还包括背景,所以这里 region proposal 的类别为 21 类。在此数据集上对 CNN 模型进行 Fine-tuning。
- 对于每一个类别训练 SVM 模型:利用 CNN 模型,对 2000 个 region proposals 提取特征,得到 的特征,对于每一个类别训练一个 SVM 模型。此处的训练样本与特征计算过程中不一致,这里 IoU<0.3 的是负样本,Ground Truth 是正样本。
- 边界框回归:得到 AlexNet 的 特征和 bounding box 的 ground truth 来训练 bounding box regression,只对那些跟 ground truth 的 IoU 超过某个阈值的 proposal 进行训练,其余的不参与,从而对 proposal 的边框修正。
2.4. RCNN 模型推理
在推理阶段(测试阶段),对于一张待检测图片,主要分为以下几个部分:
- 使用 Selective Search 提取出约 2000 个 region proposals;
- 将每一个 region proposal 缩放到 AlexNet 需要的大小,即 ,通过 AlexNet 对每一个 region proposal 计算出 4096 维特征;
- 对于每一个类,使用对应的SVM分类器计算出对应类别的概率,使用非极大值抑制(为每个类别单独调用),然后去掉一些与高分被选区域 IoU 大于阈值的候选框;
- 利用边框回归对最终的边框修正;
3. 模型存在的问题
RCNN 的提出对于目标检测领域来说是个里程碑式的进步,但是 RCNN 算法中存在许多的不足,从上述流程可以发现,可以发现:
- 过程太多,而且较为分散,同时需要存储中间的计算结果(region proposals 以及每一个 region proposal 的 CNN 特征);
- 存在重复的计算,每一个 region proposal 都需要计算 CNN 特征;
参考文献
[1] Girshick R, Donahue J, Darrell T, et al. Rich feature hierarchies for accurate object detection and semantic segmentation[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2014: 580-587.
[2] Uijlings J R R, Van De Sande K E A, Gevers T, et al. Selective search for object recognition[J]. International journal of computer vision, 2013, 104(2): 154-171.
[3] Selective Search for Object Detection (C++ / Python)
[4] JitendraMalik R G J D T D. Rich feature hierarchies for accurate object detection and semantic segmentation Supplementary material[J].
[5] 【计算机视觉——RCNN目标检测系列】一、选择性搜索详解
[6] 【计算机视觉—RCNN目标检测系列】二、边界框回归(Bounding-Box Regression)
[7] http://www.rossgirshick.info/
修订于:2026年09月19日