1. 概述
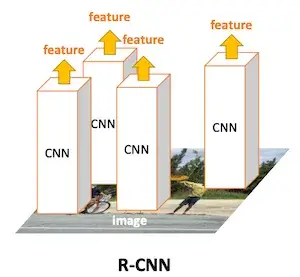
在 R-CNN[1] 算法中,首次提出使用卷积神经网络 CNN 处理目标检测的问题,回顾算法的整个过程,包含了三个主要的步骤:
- 区域提名(Region Proposal):使用 Selective Search[2] 的方法产生约 2000 个目标可能出现的位置,通常称为 Proposal。
- 特征计算:对上述 2000 个目标可能出现的位置的图像,先裁剪出来,并将其 reshape 成大小为 的图像,使用 CNN 算法,文章[1]中使用 AlexNet 卷积神经网络(当然放在当下来看,AlexNet 算不上先进的算法)进行特征计算,对于每一个图像得到一个 4096 维的特征向量;
- 分类:单独训练了一个 SVM 的分类器,对每一个类别训练一个二分类的分类器(yes/no)。
当然文中也提到了使用边框回归 Bounding Box Regression 来提升最终的边框的准确率。现在来看,在整个 R-CNN 算法中,存在两个最突出的问题:
- 过程太多,而且较为分散(上述的三步都是分散的),同时需要存储中间的计算结果(region proposals 以及每一个 region proposal 的 CNN 特征);
- 存在重复的计算,每一个 region proposal 都需要经过 CNN 计算其特征;
R-CNN 提取特征的过程如下图[3]所示:
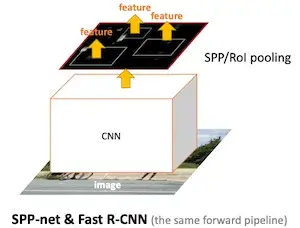
那么能不能利用 CNN 网络只对全图提取一次特征,同时,本身神经网络就具备了分类和回归的能力,那么能不能将最终 R-CNN 中的 SVM 的分类和边框回归都用神经网络来建模,这样就能通过一个网络实现目标检测。这就是 Fast R-CNN[4] 的出发点。在 Fast R-CNN 中,先在原始图像上用 Selective Search 生成候选区域,然后把候选区域坐标映射到整图 CNN 得到的特征图上,通过特征映射实现了一次 CNN 计算得到多个候选区域的特征,但是得到的特征并不能直接使用分类和回归算法,需要通过 RoI Pooling 将任意大小的 RoI 区域变成固定尺寸的特征图。其提取特征的过程如下图[3]所示:
2. Fast R-CNN 算法过程
2.1. Fast R-CNN 架构
Fast R-CNN 的架构如下图[4]所示:
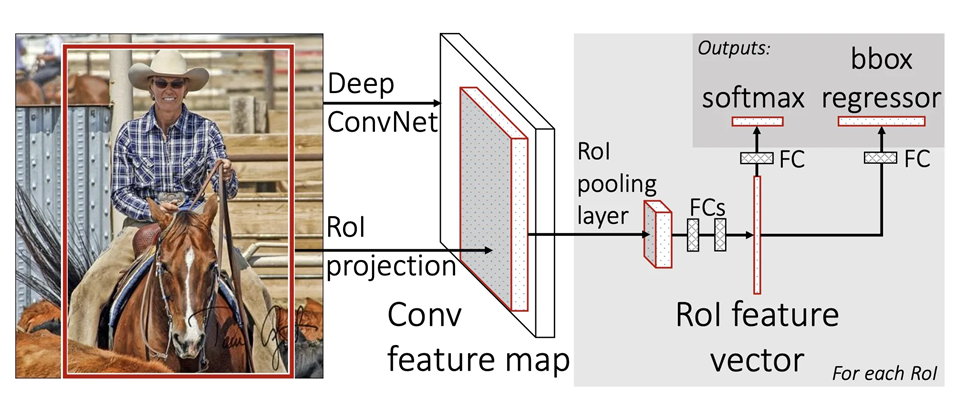
其中,左侧原图中红色框标出的 region proposal 是由 Selective Search 方法产生的,独立于当前的 Fast R-CNN 网络结构之外,对于网络,输入包括了原图 img 和由 Selective Search 产生的 region proposal:
- 由 CNN 对原图计算,得到特征图 F,即上图中中间的 Conv feature map;
- 对每一个 region proposal 利用 RoI projection 进行映射,得到原图在特征图 F 上的特征;
- 由于每个 region proposal 在特征图 F 上的大小都不一样,因此需要采用 RoI Pooling 将特征缩放到固定的大小,从而能得到 RoI feature vector,后面便顺理成章的接入到分类和回归中。
这里面涉及到 CNN 计算、RoI Projection、RoI Pooling,接下来将重点介绍下 RoI Projection 和 RoI Pooling 是如何工作的。
2.2. RoI Projection
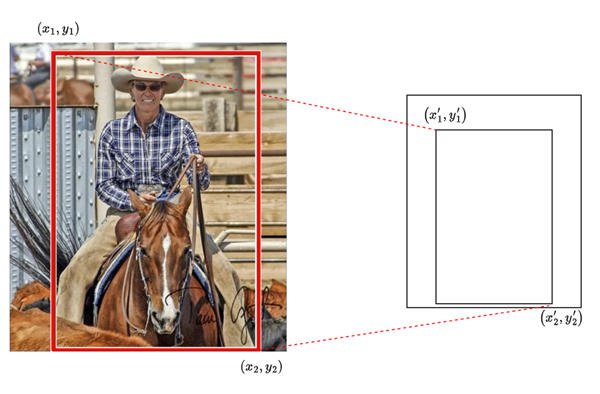
首先一张图,经过 Selective Search 生成 2000 个候选框,每一个框在原图上的坐标为 ,其中 $ \left ( x_1,y_1 \right )$ 为左上角的坐标, 为右下角的坐标。同时,原图经过 CNN 得到特征图 F,假设尺寸为 ,从原图到特征图,就会存在一个空间缩放因子:,也就是特征图相对于原图的缩放比例。将 RoI 从原图映射到特征图可以由如下的公式得到:
这样就能得到该候选框在特征图 F 上的坐标 ,由于缩放因子 可能是浮点数,这就导致对应特征图 F 上的坐标可能是浮点数。这个具体过程如下图所示:
2.3. RoI Pooling
RoI Pooling 的作用是处理每一个 RoI 在特征图 F 上的区域 ,使得每个 RoI 对应一个固定尺寸的特征图,如:。其实 RoI Pooling 的思路与空间金字塔池化[5](Spatial Pyramid Pooling)一致,其具体过程如下图所示:
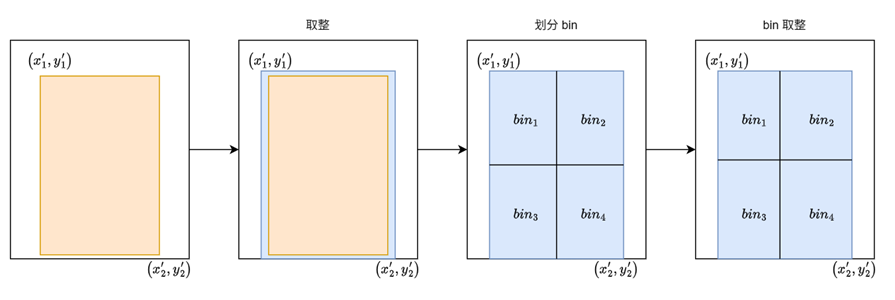
如上图所示,RoI Pooling 分为三个步骤,分别为:取整,划分 bin和每个 bin 内最大池化:
首先是取整,因为候选框在特征图 F 上的坐标 可能是浮点数,要进行 RoI Pooling,首先需要取整:
如候选框在特征图 F 上的坐标为 ,取整后为 。
第二步为划分 bin,取整后 RoI 在特征图上的宽高分别为 ,需要输出的大小为 ,则每个 bin 的大小为:
对于如上的候选框在特征图 F 上的坐标 ,也就是 ,假设需要的输出为 ,也就是 ,最终每个 bin 的大小约为:
我们发现,这里又出现了浮点数,因此也需要取整。
第三步,就是在每一个 bin 内做最大池化操作,对于每个 bin 所覆盖的特征图区域,在每个通道上分别取最大值。最终得到 的固定尺寸特征。
2.4. RoI Pooling 的缺点
由上过程不难发现,RoI Pooling 最大的问题是需要取整,这对于对位置要求严格的场景是十分不利的。在上面的 RoI Pooling 过程,连续做了两次的取整:
- RoI 映射到特征图后,坐标需要取整;
- 在划分 bin 时,bin 边界需要取整。
这会导致特征图上的 RoI 区域与原始图像中的目标位置出现空间错位。
3. 模型训练
在模型训练阶段,其实还有三个问题需要详细介绍下,分别是分类,边框回归以及最终的损失函数。
3.1. 分类
首先,对于 RoI Pooling 后出来的特征与传统的 CNN 网络一致,将特征展平并放入到一个全连接的分类网络中,得到最终的类别。有所区别的是,假设有 个类别,此时需要分类的是 个类别,多增加的一个是判断其是否为背景。
3.2. 边框回归
边框回归(Bounding Box Regression)是通过学习的方式,调整边框,让其更接近真实的目标框。我们先来理解下这个过程,假设真实的目标框 Ground Truth 为 ,这就是最终我们要学习到的目标,最初我们有的是什么?我们需要用 RoI Pooling 出来的每一个候选框的特征来预测真实的目标框:
其中, 表示的就是每一个候选框的特征。最直观的方式是根据原始坐标直接预测真实的坐标,而目标检测算法中普遍采用的是学习的当前框于目标框之间的相对变换。
首先,第一步将坐标体系改成中心点的形式。如对于候选框 ,将其表示成:,其中, 表示的是中心点的坐标, 表示的是候选框的宽高。与 的关系如下:
同样,对于真实的目标框也需要转换成中心点的表示形式:。
此时,不直接学习 这四个参数,而是学习如何从 变到 ,这里用到了四个参数 ,先上公式:
此时,只需要通过特征预测好 这四个参数,也就是:
对于一个候选框 ,再加上预测得到的 ,便可以推导真实的候选框坐标 了,公式如下:
为什么要这么设计呢?我们从一张图简单理解下,图如下:
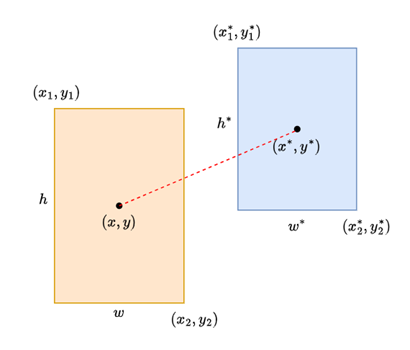
其中,黄色的 Selective Search 出来的候选框,蓝色的是目标候选框(为方便描述,故意将两个目标框分隔得比较开)。简单的描述,中心点涉及到的是平移操作,而宽高涉及到的是缩放操作,平移操作是线性的过程,而缩放操作不仅有放大,还有缩小,假设宽度放大到原来的 倍,也就是 ,缩小到原来的 ,也就是 ,通过上面的公式就很容易表示出来。
3.3. 损失函数
正如上面所述,模型的训练涉及到分类和回归,这是一个多任务损失(Multi-task Loss),损失函数为:
其中, 是分类器预测的 Softmax 概率分布 , 对应目标真实类别标签,因为第 0 个位置是背景,也就是没有目标,因此后面需要有 ,表示回归只算有目标的。 对应边界框回归预测的对应类别 的回归参数 , 对应真实目标的边界框回归参数 。
对于分类损失 ,其具体的形式为:
对于边框回归的损失 ,在文献[4]中采用的是 Smooth L1 Loss。其具体形式如下:
损失函数中的 是一个平衡系数,用于平衡分类损失与边界框回归损失。 表示的是当 满足条件时,值为 1,否则,值为 0。
4. 总结
Fast R-CNN 在 R-CNN 的基础上,通过 CNN 对全图提取特征,同时保留了 Selective Search 在原图生成 RoI 的过程,通过特征映射将原图的 RoI 映射到特征图上,最后通过 RoI Pooling 得到固定的尺寸,方便后续的分类和回归计算。纵观整个过程,Proposal Region 的特征计算只需要一次 CNN 计算加上特征映射就能完整,同时,摒弃掉了 R-CNN 中 SVM 的分类计算,实现了部分模块的统一。
参考文献
[1] Girshick R, Donahue J, Darrell T, et al. Rich feature hierarchies for accurate object detection and semantic segmentation[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2014: 580-587.
[2] Uijlings J R R, Van De Sande K E A, Gevers T, et al. Selective search for object recognition[J]. International journal of computer vision, 2013, 104(2): 154-171.
[4] Girshick R. Fast r-cnn[C]//Proceedings of the IEEE international conference on computer vision. 2015: 1440-1448.
[5] He K, Zhang X, Ren S, et al. Spatial pyramid pooling in deep convolutional networks for visual recognition[J]. IEEE transactions on pattern analysis and machine intelligence, 2015, 37(9): 1904-1916.