1. REINFORCE 算法存在的问题
1.1. 存在的问题
REINFORCE[1] 是最经典、最基础的 Policy Gradient(策略梯度)算法,由 Ronald J. Williams (1992) 提出。在策略梯度原理中,要估计期望,REINFORCE 中是使用多次采样回报的方式估计回报的梯度的,简单来说就是:
我们知道 是通过采样计算出来的,采样的结果就存在随机性,这就导致了 波动极大,简单来说就是方差较大。
1.2. 偏差与方差
在强化学习的训练中,存在着偏差与方差的问题,对于偏差和方差的定义,如下:
偏差:有偏差的估计器不能很好地表示/拟合原始指标。形式上,如果估计量的期望值等于原始度量,则它是无偏的。偏差会导致局部最优解。
方差:具有高方差的估计量具有很大的值分布。理想情况下,无偏估计器应该具有低方差,以在输入中始终匹配原始度量。形式上,这与测量任何随机变量的方差相同。方差会导致需要更多样本才能收敛。
简单来说,偏差就是模型预测的期望与真实值之间的系统性偏离,反映模型的拟合能力。方差就是模型在不同训练集上预测结果的波动程度,反映模型对数据随机性的敏感度。从下面这张图[2]看一下偏差和方差的直观理解:
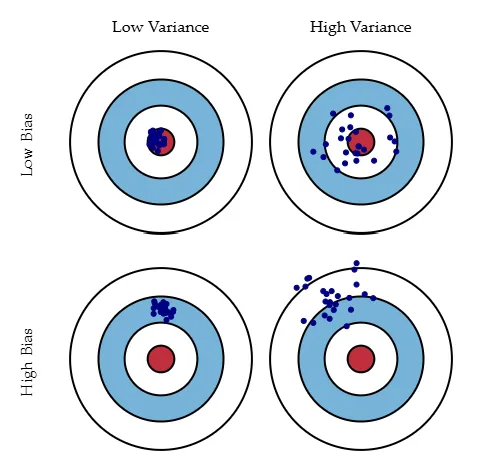
现在回过头来再来 REINFORCE 算法,由于其基于的是蒙特卡洛方法,通过采样的方式获得真实的回报,进而计算出回报的期望,但是因为蒙特卡洛方法本身在采样的过程中存在随机性,导致了每一次采样的过程之间存在差异,这就是方差产生的原因。
1.3. 减小方差
先上结论,在 REINFORCE 中的梯度公式中,减去一个与动作无关的基线 ,能保证期望不变,同时减少方差。
1.3.1. 期望不变
先来看期望,令:
引入与动作无关的基线 后,变成:
对 求期望,并展开,得到:
现只需要证明:。为了简单,我们只取其中一项,即证明:。因为 与动作 无关,可以得到:
对内部的 求期望有:
而由于 ,且 ,最终可知:
从而 。因此,减去一个与动作无关的基线 ,对整体的期望并没有影响。
1.3.2. 方差减小
对于 ,我们首先以单时间步为例:
取 ,对其求方差:
根据方差的定义可知:,则上述的方差变成:
因为 ,与 无关,因此我们只看前面那部分,令其为 ,并对其展开:
这是一个关于 的二次函数,同时,注意到 ,此时关于 的二次函数有最小值,要求 的最小值,对其求导:
当 时,取得最小值,即:
但是上述的值是很难计算的,此时,可以通过一些近似的方式,找到一些近似的解。其中一种近似就是取 。为了得到这个等式,需要用到一个假设“ 在不同动作之间变化不大”,即 。则分子为:
分母为:
而因为 ,因此,分母为:
最终 为:
根据定义,有:
因此有:。
2. 算法实现
采用的环境是 Cart Pole[3],这是一个连续状态的问题。该问题的动作空间中的动作有两个,状态是由 4 个值确定的,分别为 Cart Position,Cart Velocity,Pole Angle 和 Pole Angular Velocity。更多详细情况如参考文献[3]。
2.1. 构建网络
除了需要创建一个策略网络之外,还需要构建一个价值网络,用于计算 ,以最简单的三层 DNN 网络为例,分别定义为 PolicyNetwork 类和 ValueNetwork 类:
# INFO: 策略网络
class PolicyNetwork(nn.Module):
    def __init__(self, n_observations, n_actions, hidden_dim=128):
        super(PolicyNetwork, self).__init__()
        self.fc1 = nn.Linear(n_observations, hidden_dim)
        self.fc2 = nn.Linear(hidden_dim, hidden_dim)
        self.fc3 = nn.Linear(hidden_dim, n_actions)

    def forward(self, x):
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return F.softmax(x, dim=-1)   # 输出动作概率分布

# INFO: 价值网络
class ValueNetwork(nn.Module):
    def __init__(self, n_observations, hidden_dim=128):
        super(ValueNetwork, self).__init__()
        self.fc1 = nn.Linear(n_observations, hidden_dim)
        self.fc2 = nn.Linear(hidden_dim, hidden_dim)
        self.fc3 = nn.Linear(hidden_dim, 1)

    def forward(self, x):
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        return self.fc3(x)
2.2. 训练
有了以上的结构的准备,接下来就是要按照上述的训练流程,实施“采样->更新”这样的循环,直接上代码:
class REINFORCEAgent:
    def __init__(self, env, device):
        self.env = env
        self.device = device

        self.n_actions = env.action_space.n
        self.n_observations = env.observation_space.shape[0] # 连续空间

        # INFO: 策略网络
        self.policy_net = PolicyNetwork(self.n_observations, self.n_actions).to(self.device)

        self.policy_net_lr = 3e-4 # 学习率
        self.policy_net_optimizer = optim.AdamW(self.policy_net.parameters(), lr=self.policy_net_lr, amsgrad=True)
        self.policy_net_scheduler = StepLR(self.policy_net_optimizer, step_size=100, gamma=0.95)

        # INFO: 价值网络
        self.value_net = ValueNetwork(self.n_observations).to(self.device)

        self.value_net_lr = 1e-4
        self.value_net_optimizer = optim.AdamW(self.value_net.parameters(), lr=self.value_net_lr, amsgrad=True)
        self.value_net_scheduler = StepLR(self.value_net_optimizer, step_size=100, gamma=0.95)

        # INFO: 其他参数
        self.gamma = 0.99
        self.num_episodes = 2000

    def __update_policy(self, saved_log_probs, saved_rewards, state_list):
        # INFO: 统计回报
        G = 0
        discounted_rewards = []
        for reward in reversed(saved_rewards):
            G = reward + self.gamma * G
            discounted_rewards.insert(0, G)
        # 归一化(可选,有助于稳定训练)
        discounted_rewards = torch.tensor(discounted_rewards)
        discounted_rewards = (discounted_rewards - discounted_rewards.mean()) / (discounted_rewards.std() + 1e-9)

        # INFO: 价值网络的损失函数
        state_list = torch.cat(state_list)
        v_tensor_list = self.value_net(state_list).squeeze(-1)
        value_loss = F.mse_loss(v_tensor_list, discounted_rewards)
        self.value_net_optimizer.zero_grad()
        value_loss.backward()
        self.value_net_optimizer.step()

        # INFO: 策略网络的损失函数
        policy_loss = []
        for log_prob, G_t, v in zip(saved_log_probs, discounted_rewards, v_tensor_list):
            # 损失 = - log_prob * (G_t-v)   (梯度上升转换为梯度下降)
            policy_loss.append(-log_prob * (G_t - v.detach()))
        self.policy_net_optimizer.zero_grad()
        policy_loss = torch.cat(policy_loss).sum()
        ret_policy_loss = policy_loss.item()
        policy_loss.backward()
        self.policy_net_optimizer.step()

        return ret_policy_loss

    def train(self):
        episode_rewards = []
        train_loss = []
        for episode in range(self.num_episodes):
            # INFO: 1. 模拟采样
            state, _ = self.env.reset() # 重置环境
            state = torch.tensor(state, dtype=torch.float32, device=self.device).unsqueeze(0)
            episode_reward = 0
            done = False
            # INFO: 策略更新的两个参数
            saved_log_probs = []
            saved_rewards = []
            state_list = [] # 记录状态
            while not done:
                # INFO: 选择动作
                probs = self.policy_net(state)
                state_list.append(state)
                m = torch.distributions.Categorical(probs=probs)
                action = m.sample()
                saved_log_probs.append(m.log_prob(action))

                # INFO: 执行动作
                observation, reward, terminated, truncated, _ = self.env.step(action.item())
                done = terminated or truncated

                if terminated:
                    next_state = None
                else:
                    next_state = torch.tensor(observation, dtype=torch.float32, device=self.device).unsqueeze(0)

                saved_rewards.append(reward)

                episode_reward += reward
                state = next_state

            # INFO: 2. 策略更新
            ret_loss = self.__update_policy(saved_log_probs, saved_rewards, state_list)
            episode_rewards.append(episode_reward)
            train_loss.append(ret_loss)
            self.policy_net_scheduler.step()
            self.value_net_scheduler.step()

            if (episode+1) % 100 == 0:
                avg_reward = np.mean(episode_rewards[-100:])
                print(f"Episode {episode+1}, Average Reward (last 100): {avg_reward:.2f}")

        # INFO: 最终保存出模型
        torch.save(self.policy_net.state_dict(), 'reinforce_cartpole.pth')

        # INFO: 保存最终的训练状态
        fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(8, 4))  # 1行2列,图形尺寸可调

        ax1.plot(episode_rewards)
        ax1.set_xlabel("episode")
        ax1.set_ylabel('reward')
        ax1.set_title('Reward')

        ax2.plot(train_loss)
        ax2.set_xlabel("epoch")
        ax2.set_ylabel('loss')
        ax2.set_title('loss')

        plt.tight_layout()
        plt.savefig("reward_loss.png")
有了完整的过程,启动训练:
if __name__ == "__main__":
    device = torch.device("cuda" if torch.cuda.is_available() else"cpu")
    env = gym.make("CartPole-v1")
    reinforce_agent = REINFORCEAgent(env, device=device)
    reinforce_agent.train()
    env.close()
2.3. 结果与测试
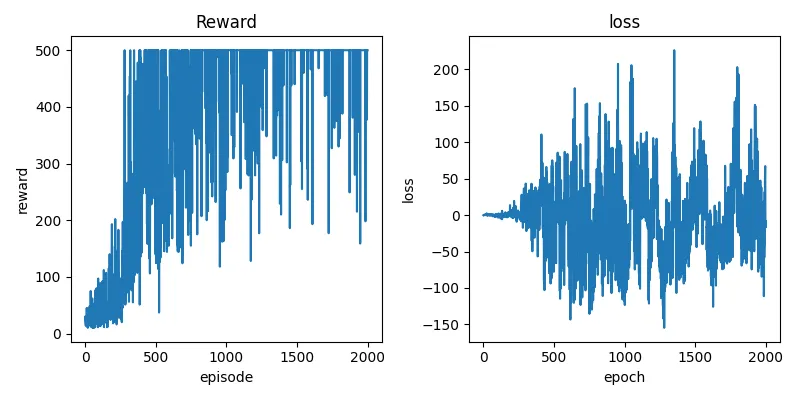
经过简单的训练,最终保存出名为 reinforce_cartpole.pth 目标网络的模型,同时我们可以看到训练过程中的数据表现:
再写一段测试的脚本,用于测试模型的表现,如下:
if __name__ == "__main__":
    mode = "test"
    device = torch.device("cuda" if torch.cuda.is_available() else"cpu")
    if mode == "train":
        env = gym.make("CartPole-v1")
        reinforce_agent = REINFORCEAgent(env, device=device)
        reinforce_agent.train()
        env.close()
    else:
        test_env = gym.make("CartPole-v1", render_mode='human')
        n_actions = test_env.action_space.n
        n_observations = test_env.observation_space.shape[0] # 连续空间
        # INFO: 定义模型
        policy_net = PolicyNetwork(n_observations, n_actions).to(device)
        # 2. 加载状态字典
        state_dict = torch.load('reinforce_cartpole.pth', map_location=torch.device('cpu'))  # 或 'cuda'

        # 3. 将参数加载到模型中
        policy_net.load_state_dict(state_dict)

        # 4. 设置为评估模式(如果只做推理)
        policy_net.eval()

        num_episodes = 10

        for ep in range(num_episodes):
            state, _ = test_env.reset()
            done = False
            total_reward = 0
            while not done:
                test_env.render()

                state = torch.tensor(state, dtype=torch.float32, device=device)
                probs = policy_net(state)
                m = torch.distributions.Categorical(probs=probs)
                action = m.sample()

                next_state, reward, terminated, truncated, _ = test_env.step(action.item())
                done = terminated or truncated
                total_reward += reward
                if done:
                    print(f"terminated: {terminated}, truncated: {truncated}")
                    break
                state = next_state
            print(f"Test Episode {ep+1}: Total Reward = {total_reward}")
        test_env.close()
3. 总结
REINFORCE 算法是最经典、最基础的 Policy Gradient(策略梯度)算法,由 Ronald J. Williams (1992) 提出,直接对策略建模,寻找到最优的策略使得总体回报的期望最高。在此基础上,在 REINFORCE 的梯度公式中,减去一个与动作无关的基线 ,可以在不引入偏差的情况下降低梯度方差,从而提升训练稳定性,并通常提高收敛效率。
参考文献
[1] https://felixzhao.cn/article/90/
[2] https://scott.fortmann-roe.com/docs/BiasVariance.html
[3] https://gymnasium.farama.org/environments/classic_control/cart_pole/