1. 概述
在目标检测中,除了检测精度,另一个对于算法的关注点就是检测的速度。R-CNN 系列算法已经验证了 CNN 算法在目标检测中可行性,同时,从 R-CNN[1] 到 Fast R-CNN[2] ,最后到 Faster R-CNN[3] ,实现了仅通过 CNN 网络就可以实现目标检测,而无需其他的算法,但是 Faster R-CNN 毕竟还是两阶段(two-stage)的,简单来说,就是:
阶段一:通过 RPN 生成候选框
阶段二:通过回归和分类对生成的候选框做精细化处理
2016 年,YOLO(You Only Look Once)[4] 的提出,实现了从两阶段(two-stage)到单阶段(one-stage)的成功跨越,从 YOLO 的全称也能看出来其想要达成的目标,就是速度。因为后续在 YOLO 系列上的不断演进,这个版本的 YOLO 也被民间称为 YOLO v1。
YOLO v1 的核心思想是将目标检测统一为一个单阶段、端到端的预测问题:以整张图像为输入,经过一个卷积神经网络,直接输出 S × S S\times S S × S
2. YOLO v1 算法过程
2.1. YOLO v1 的网络结构
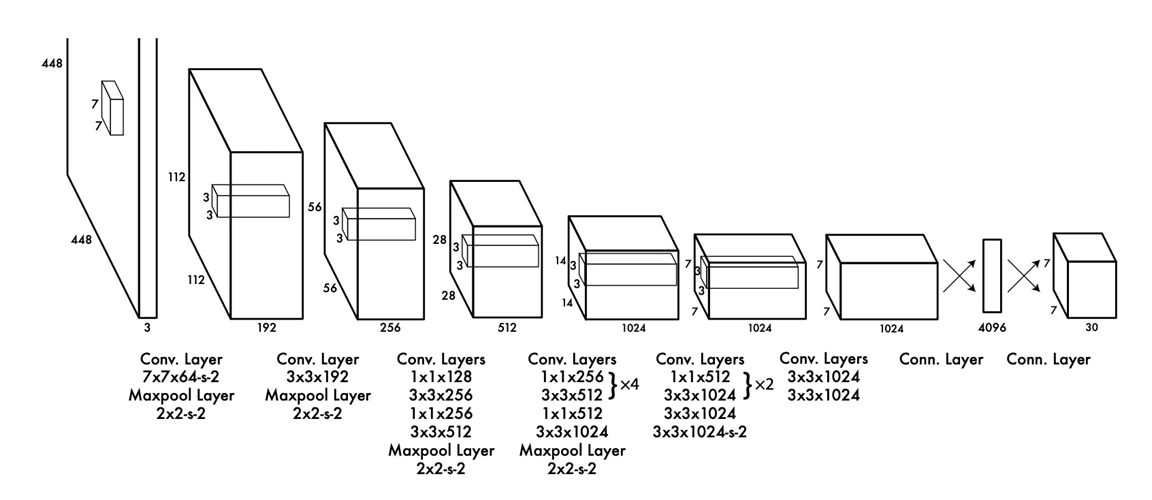
YOLO v1 的网络结构如下图所示:
YOLO v1 的网络结构是一种典型的 CNN 网络结构,其中,网络的输入是 448 × 448 × 3 448\times 448\times 3 448 × 448 × 3 7 × 7 × 1024 7\times 7\times 1024 7 × 7 × 1024 7 × 7 × 30 7\times 7\times 30 7 × 7 × 30
2.2. YOLO v1 的运行机制
与传统的两阶段的算法不一样的地方是,在 YOLO v1 中,不再需要单独的一个模块或算法(如 Selective Search,RPN)来专门的产生一系列的锚框(Anchor)。在 YOLO v1 中则是采用的另一种更为巧妙的方式。
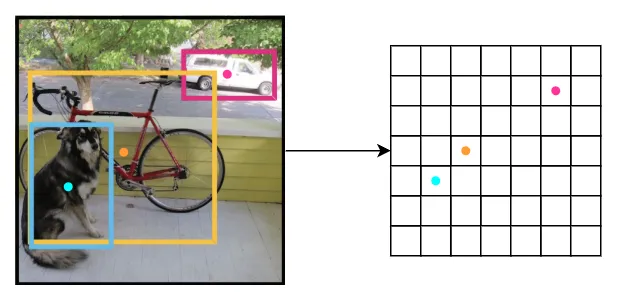
首先,从上面的网络结构图中可以看到,对于 448 × 448 × 3 448\times 448\times 3 448 × 448 × 3 7 × 7 × 1024 7\times 7\times 1024 7 × 7 × 1024 7 × 7 7\times 7 7 × 7
我们来具体解释下这个过程:
首先,对于原始图像(假设为 448 × 448 × 3 448\times 448\times 3 448 × 448 × 3 1024 1024 1024 S × S S\times S S × S 7 × 7 7\times 7 7 × 7
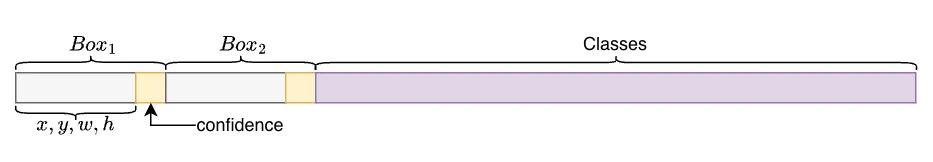
对于上述的 7 × 7 7\times 7 7 × 7 B B B ( x , y , w , h ) \left ( x,y,w,h \right ) ( x , y , w , h ) C C C S × S × ( 5 × B + C ) S\times S\times \left(5\times B + C \right) S × S × ( 5 × B + C ) 7 × 7 7\times 7 7 × 7 2 2 2 20 20 20 S = 7 , B = 2 , C = 20 S=7,B=2,C=20 S = 7 , B = 2 , C = 20 7 × 7 × 30 7\times 7\times 30 7 × 7 × 30
上图中特征层三个点就对应了原图中的三个目标的中心点,这样,这三个网络就负责了上面的预测工作。剩下还有两个问题,第一个是损失函数是什么?第二个是正负样本如何确定?
2.3. 损失函数
首先,我们来看损失函数,在 YOLO v1 中,损失函数由三部分组成,分别是坐标预测的损失,是否包含目标预测的损失以及类别预测的损失,先看第一部分,坐标预测的损失,其形式如下:
∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j [ ( x i − x ^ i ) 2 + ( y i − y ^ i ) 2 ] + ∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j [ ( w i − w ^ i ) 2 + ( h i − h ^ i ) 2 ] \sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left [ \left ( x_i-\hat{x}_i \right )^2+\left ( y_i-\hat{y}_i \right )^2 \right ]
+\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left [ \left ( \sqrt{w_i}-\sqrt{\hat{w}_i} \right )^2+\left ( \sqrt{h_i}-\sqrt{\hat{h}_i} \right )^2\right ] i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj [ ( x i − x ^ i ) 2 + ( y i − y ^ i ) 2 ] + i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj [ ( w i − w ^ i ) 2 + ( h i − h ^ i ) 2 ]
其中,1 i j o b j \mathbb{1}_{ij}^{obj} 1 ij o bj i i i j j j 1 i j o b j = 1 \mathbb{1}_{ij}^{obj}=1 1 ij o bj = 1 1 i j o b j = 0 \mathbb{1}_{ij}^{obj}=0 1 ij o bj = 0 i i i j j j w \sqrt{w} w h \sqrt{h} h
损失函数的第二部分是针对是否包含目标预测的损失,其形式如下:
∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j ( C i − C ^ i ) 2 + ∑ i = 0 S 2 ∑ j = 0 B 1 i j n o o b j ( C i − C ^ i ) 2 \sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left ( C_i-\hat{C}_i \right )^2
+\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{noobj}\left ( C_i-\hat{C}_i \right )^2 i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj ( C i − C ^ i ) 2 + i = 0 ∑ S 2 j = 0 ∑ B 1 ij n oo bj ( C i − C ^ i ) 2
其中,1 i j o b j \mathbb{1}_{ij}^{obj} 1 ij o bj 1 i j n o o b j \mathbb{1}_{ij}^{noobj} 1 ij n oo bj 1 i j o b j \mathbb{1}_{ij}^{obj} 1 ij o bj C C C
P r ( O b j e c t ) ∗ I O U p r e d t r u t h Pr\left ( Object \right )\ast IOU_{pred}^{truth} P r ( O bj ec t ) ∗ I O U p re d t r u t h
从公式来看,Confidence 是两部分的组合,一部分是有目标的概率,代表了这个框是否包含目标,另一部分是预测和真实的框之间的 IoU,代表了这个框到底转不准。现在将上面的计算拆开来看:
当第 i i i j j j
此时,1 i j o b j = 1 \mathbb{1}_{ij}^{obj}=1 1 ij o bj = 1 1 i j n o o b j = 0 \mathbb{1}_{ij}^{noobj}=0 1 ij n oo bj = 0 C ^ i = I o U \hat{C}_i=IoU C ^ i = I o U C i C_i C i I o U IoU I o U
当第 i i i j j j
此时,1 i j o b j = 0 \mathbb{1}_{ij}^{obj}=0 1 ij o bj = 0 1 i j n o o b j = 1 \mathbb{1}_{ij}^{noobj}=1 1 ij n oo bj = 1 C ^ i = 0 \hat{C}_i=0 C ^ i = 0 0 0 0
第三部分是类别预测的损失,其形式如下:
∑ i = 0 S 2 1 i o b j ∑ c ∈ c l a s s e s ( p i ( c ) − p ^ i ( c ) ) 2 \sum_{i=0}^{S^2}\mathbb{1}_{i}^{obj}\sum_{c\in classes}\left ( p_i\left ( c \right )-\hat{p}_i\left ( c \right ) \right )^2 i = 0 ∑ S 2 1 i o bj c ∈ c l a sses ∑ ( p i ( c ) − p ^ i ( c ) ) 2
这部分的损失只针对有目标的,去优化各类的概率值。
为了将三部分融合在一起,这里也是设计了相应的系数,最终得到损失函数为:
λ c o o r d ∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j [ ( x i − x ^ i ) 2 + ( y i − y ^ i ) 2 ] + λ c o o r d ∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j [ ( w i − w ^ i ) 2 + ( h i − h ^ i ) 2 ] + ∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j ( C i − C ^ i ) 2 + λ n o o b j ∑ i = 0 S 2 ∑ j = 0 B 1 i j n o o b j ( C i − C ^ i ) 2 + ∑ i = 0 S 2 1 i o b j ∑ c ∈ c l a s s e s ( p i ( c ) − p ^ i ( c ) ) 2 \lambda _{coord}\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left [ \left ( x_i-\hat{x}_i \right )^2+\left ( y_i-\hat{y}_i \right )^2 \right ]\\
+\lambda _{coord}\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left [ \left ( \sqrt{w_i}-\sqrt{\hat{w}_i} \right )^2+\left ( \sqrt{h_i}-\sqrt{\hat{h}_i} \right )^2\right ]\\
+\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left ( C_i-\hat{C}_i \right )^2\\
+\lambda _{noobj}\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{noobj}\left ( C_i-\hat{C}_i \right )^2\\
+\sum_{i=0}^{S^2}\mathbb{1}_{i}^{obj}\sum_{c\in classes}\left ( p_i\left ( c \right )-\hat{p}_i\left ( c \right ) \right )^2 λ coor d i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj [ ( x i − x ^ i ) 2 + ( y i − y ^ i ) 2 ] + λ coor d i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj [ ( w i − w ^ i ) 2 + ( h i − h ^ i ) 2 ] + i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj ( C i − C ^ i ) 2 + λ n oo bj i = 0 ∑ S 2 j = 0 ∑ B 1 ij n oo bj ( C i − C ^ i ) 2 + i = 0 ∑ S 2 1 i o bj c ∈ c l a sses ∑ ( p i ( c ) − p ^ i ( c ) ) 2
在参考文献[4]中设置的 λ c o o r d = 5 \lambda _{coord}=5 λ coor d = 5 λ n o o b j = 0.5 \lambda _{noobj}=0.5 λ n oo bj = 0.5
2.4. 正负样本
在 YOLO v1 中,对于原始图像(假设为 448 × 448 × 3 448\times 448\times 3 448 × 448 × 3 1024 1024 1024 S × S S\times S S × S 7 × 7 7\times 7 7 × 7
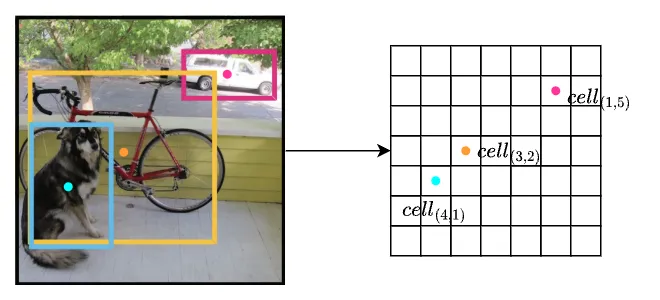
以狗为 Ground Truth 为例,该 Ground Truth 的中心落在第 4 行(从 0 开始计数),第 1 列,该位置称为 c e l l ( 4 , 1 ) cell_{\left(4,1\right)} ce l l ( 4 , 1 ) B B B
那负样本呢?最直接的就是所有没有 Ground Truth 的中心落到的 cell 都是负样本。另一部分则是负责目标的 cell 中的 B B B
如上图,在这种情况下,正负样本严重的不平衡,假设此时就 3 3 3 2 × 7 × 7 = 98 2\times 7\times 7=98 2 × 7 × 7 = 98 3 3 3 98 − 3 = 95 98-3=95 98 − 3 = 95 3 : 95 3:95 3 : 95
∑ i = 0 S 2 ∑ j = 0 B 1 i j o b j ( C i − C ^ i ) 2 + ∑ i = 0 S 2 ∑ j = 0 B 1 i j n o o b j ( C i − C ^ i ) 2 \sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{obj}\left ( C_i-\hat{C}_i \right )^2
+\sum_{i=0}^{S^2}\sum _{j=0}^{B}\mathbb{1}_{ij}^{noobj}\left ( C_i-\hat{C}_i \right )^2 i = 0 ∑ S 2 j = 0 ∑ B 1 ij o bj ( C i − C ^ i ) 2 + i = 0 ∑ S 2 j = 0 ∑ B 1 ij n oo bj ( C i − C ^ i ) 2
如果直接按照上面这样,加号前面那部分代表的是正样本,加号后面那部分代表的是负样本,如果两者的权重一样的话,那么大量负样本的 loss 就会很容易淹没少量正样本的 loss,因此在 YOLO v1 中,在负样本的损失前面增加了权重 λ n o o b j = 0.5 \lambda _{noobj}=0.5 λ n oo bj = 0.5
3. 总结
YOLO v1 的提出开创了 one-stage 的目标检测,检测速度得到了极大提升,但是从上述 YOLO v1 的整个过程来看,YOLO v1 中也存在着很多的问题,如每个 cell 预测 B 个候选框,如果两个物体靠得很近,检测效果并不好,同时也导致对密集物体的检测效果欠佳;算法中对负样本的定义,导致了大量背景负样本的存在,缺乏对困难负样本的学习,这也会导致模型效果受到影响。得益于其优秀的架构和性能,这些问题也就吸引了众多开发者为其添砖加瓦,改进其效果,这就有了后续的各个版本。
参考文献
[1] Girshick R, Donahue J, Darrell T, et al. Rich feature hierarchies for accurate object detection and semantic segmentation[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2014: 580-587.
[2] Girshick R. Fast r-cnn[C]//Proceedings of the IEEE international conference on computer vision. 2015: 1440-1448.
[3] Ren S, He K, Girshick R, et al. Faster r-cnn: Towards real-time object detection with region proposal networks[J]. Advances in neural information processing systems, 2015, 28.
[4] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.