1. 概述
FCOS[1] 全称是 Fully Convolutional One-Stage Object Detection,是一种无锚框(Anchor-Free)的单阶段目标检测算法。YOLO v1[2] 也是一种无锚框的单阶段目标检测算法,但是受限于算法的效果,在后期的版本,如 YOLO v2[3] 中也是重新增加了 Anchor,在 YOLO v2 中也是使用了 K-Means 算法对训练集中的 Ground Truth 进行聚类,从而找到最能代表当前目标框的范式,这一点也验证了基于 Anchor(Anchor-Based)方法的弊端:
- 框的大小、宽高比、不同框的数量,这些超参对检测器的效果影响很大。
- 框的大小和宽高比都已经固定了,一些小目标比较难检测,为此需要设计很多的框
除此之外,为了提高召回,一般会设计大量的 Anchor,然而,目标的数量是很少的,这也引入了大量的负样本,导致模型在训练的时候正负样本的不均衡。
众多的一些问题,使得研究者们不断探索 Anchor-Free 的方法。FCOS 正是其中的一种解决方案。
2. FCOS 算法原理
2.1. FCOS 算法的网络架构
首先来看一下 FCOS 的基本网络结构,如下所示:
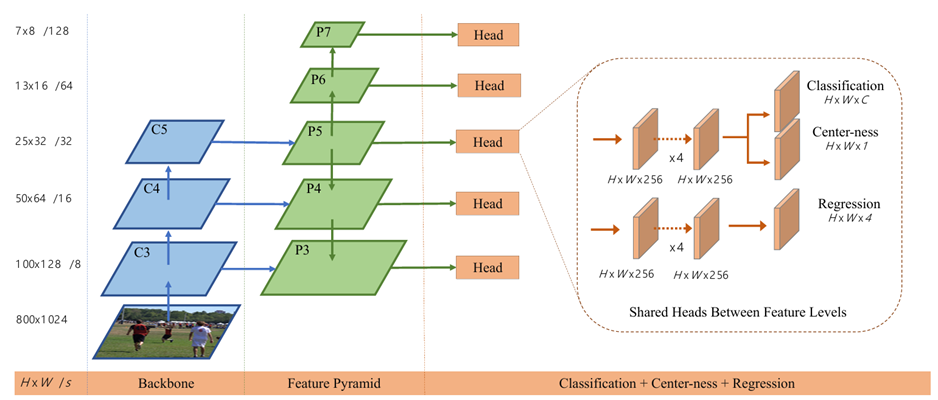
在 FCOS 中除了基本的 CNN 网络结构之外还引入了特征金字塔 FPN,用于在不同的特征曾检测不同大小的目标。具体来说,FCOS 的网络结构采用了骨干网络 Backbone + 特征金字塔 Feature Pyramid + 共享检测头 Head 的模式:
- 骨干网络(Backbone):通常采用 ResNet-50 等 CNN 结构,用于提取图像的多层次特征;
- 特征金字塔网络(FPN):骨干网络输出的 C3、C4、C5 特征图经过 FPN 处理,生成 P3 到 P7 共 5 个不同尺度的特征层(下采样率从 8 到 128),其中,浅层特征图(如 P3)的分辨率较高,用于检测小目标,深层特征图(如 P7)的语义信息丰富,用于检测大目标;
- 共享检测头(Shared Head):P3 到 P7 这 5 个特征层共享同一个检测头。该检测头包含三个并行的分支,分别负责分类、中心度(Center-ness)预测和边界框回归。
有了网络的基本结构之后,在上面已经提及到 FCOS 中是没有 Anchor 的,那么,FCOS 是如何完成目标检测任务的呢?
2.2. FCOS 算法的运行机制
回顾下,在 YOLO v1 中,其运行机制如下[4]:
对于 的图像,经过一系列卷积+池化的操作后,得到 的语义特征层,YOLO v1 的操作只是在这个语义特征层上展开的,而没有采用 FPN。对于每一个通道的语义层,天然划分成 的网格,而在 YOLO v1 中,每个网格分别负责预测中心点落在该网格内的目标。我们可以通过下图描述下这个过程:
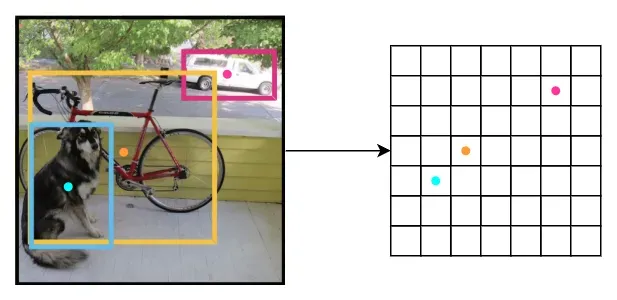
- 首先,对于原始图像(假设为 ),经过一系列的卷积+池化,得到了多个通道的语义特征层(假设通道为 ),这个时候每个通道就被划分成了 (假设每个通道为 );
- 对于上述的 个格子,每个网格都要预测 个 Bounding box,每个 Bounding box 要预测 和是否存在目标的置信度 confidence,一共是 5 个值。除此之外,每个网格还要预测一个类别信息,记为 个类,网络输出就是一个 的张量。在文献[4]中,YOLO v1 把一张图片划分为了 个网格,并且每个网格预测 个 Bounding Box, 个类别,也就是 。那么网络输出的大小为:。如下所示:
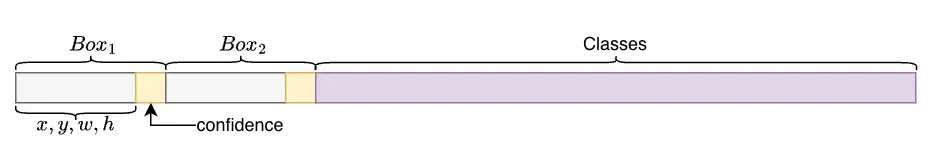
上图中特征层三个点就对应了原图中的三个目标的中心点,这样,这三个网络就负责了上面的预测工作。
在 FCOS 中有一些与此相通的逻辑,但也有些不同,为了方便描述,我们在此就取一个语义特征层(多个语义特征层,只是并行的操作而已)。在原图的 Ground Truth 中的任意一点,如上图的“狗”所在的 Ground Truth 中的淡蓝色的点(我们不要把它当成中心点,可以是 Ground Truth 中的任意一点),在特征图上有一个点与其对应,如右侧特征图上的淡蓝色的点,这两个点是相互对应的。与 YOLO v1 中不同的是,在 FCOS 算法中,针对特征图的每一个位置,预测的是分类,边界框回归,除此之外,还有一个中心度(Center-ness)的预测,其中,分类的预测与 YOLO v1 中一致,后面我们将重点介绍下边界框回归和中心都预测。
在 Inference 时,给定输入图像,网络输出每个位置的类别得分、回归距离和中心度得分。后处理阶段,将中心度与分类分数相乘得到最终置信度,然后通过非极大值抑制(NMS)过滤重叠的预测框,得到最终检测结果。
2.3. 边界框回归
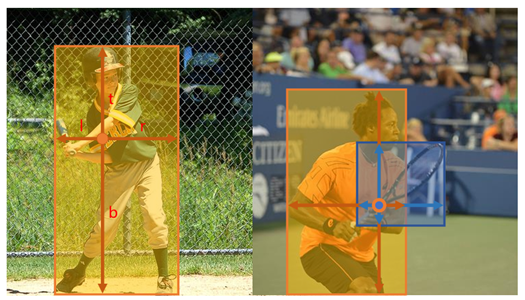
在 YOLO v1 中预测的边界框是 ,其中, 代表的是中心点坐标, 代表的是边界框的宽高,而在 FCOS 中,则是预测的是特征图上的 对应的原图上的点到左、上、右和下四个边界的距离,也就是:
其中, 表示的是该点到左边界的距离, 表示的是到上边界的距离, 表示的是到右边界的距离, 表示的是到下边界的距离。具体如下图所示:
2.4. 中心度(Center-ness)
在特征图上,在原图上可能会存在多个点落在同一个 Ground Truth 中,那些越靠近中心点预测出来的边界框理应可信度更高,因此对于特征图上的每一个位置需要判定该位置预测出来的边界框的可信度,在 FCOS 算法中就引入了中心度(Center-ness)的概念,这是 FCOS 的一个关键的概念。可信度的计算方法如下:
其中, 表示的是特征图上的 位置预测出的距离边界框的左、上、右和下四个边界的距离,如下图所示:
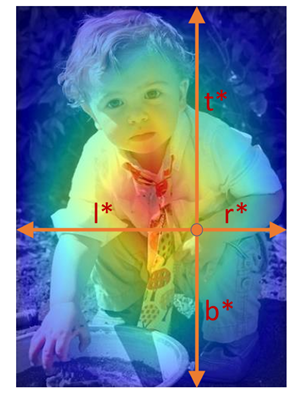
的值在 之间,当正好居中时,即 时,,而当 中任意一个为 0 时,。
2.5. 正负样本匹配
FCOS 的样本匹配规则非常直观:对于特征图上的一个位置,如果它落入了某个真实边界框 Ground Truth 内部,则被标记为正样本,其类别即为该 Ground Truth 的类别;否则为负样本。
这里有一个问题,也被称为“模糊样本”问题,即存在一个位置落在多个 Ground Truth 的情况,这种样本称为模糊样本。在 FCOS 中引入了中心采样(Center Sampling)策略,即将正样本的判定范围限制在 Ground Truth 中心区域的一个子区域内,从而减少模糊样本的数量。
2.6. 损失函数
现在来到了最后一个环节,也就是 FCOS 的损失函数,上面也介绍到,FCOS 的损失函数由三部分构成:
- 分类损失:采用 Focal Loss,以解决正负样本不平衡问题。
- 回归损失:仅对正样本计算,采用 GIoU Loss,能更好地衡量边界框的重叠程度。
- 中心度损失:采用二元交叉熵(BCE)损失进行训练。
总的损失公式如下:
其中, 为正样本数量, 为位置 的类别预测, 为位置 的类别目标, 为位置 的回归预测 , 为位置 的回归目标, 为位置 的中心度预测, 为位置 的中心度目标, 是指示函数,表示只对正样本生效, 和 是权重。
由于负样本远多于正样本,直接使用交叉熵会导致正负样本极度不平衡,因此采用分类损失采用 Focal Loss,其形式为:
其中, 是模型对真实类别的预测概率, 为平衡因子,文献[1]中取 , 为聚焦参数,文献[1]中取 。对于正样本, 是真实类别的预测概率;对于负样本, 是背景类别的预测概率。使用 Focal Loss,能降低易分类样本的权重,让模型更关注难分类样本,缓解正负样本不平衡问题。
回归损失采用的是 GIoU Loss,
其中,GIoU 的形式为:
其中, 为预测框, 为真实框, 是能够同时包含 和 的最小闭包区域, 是交并比。
中心度损失使用的是二元交叉熵(BCE),其形式为:
其中: 是中心度预测值, 是中心度目标值。中心度目标由回归目标计算得到,公式如下:
3. 总结
在 FCOS 算法中,完全移除了与锚框相关的复杂计算和大量超参数,使模型设计更简单,训练更稳定,同时,FCOS 通过逐像素预测和中心度这两个核心设计,在保持单阶段检测器速度优势的同时,实现了与两阶段检测器相媲美的精度,为后续的无锚框检测算法奠定了重要基础。
参考文献
[1] Tian Z, Shen C, Chen H, et al. Fcos: Fully convolutional one-stage object detection[C]//2019 IEEE/CVF international conference on computer vision (ICCV). Ieee, 2019: 9626-9635.
[2] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.
[3] Redmon J, Farhadi A. YOLO9000: better, faster, stronger[C]//2017 IEEE conference on computer vision and pattern recognition (CVPR). Ieee, 2017: 6517-6525.