1. 概述
特征金字塔网络(Feature Pyramid Network,FPN)[1]是在 2017 年提出的一种多尺度特征提取结构。在众多的目标检测算法中,都有其身影,如 RetinaNet[2],FCOS[3] 等。特征金字塔 FPN 并不是一个完整的算法,而是特征提取过程中一个重要的组件,概括起来就是:FPN 通过“自顶向下路径 + 横向连接”的策略,能够把高层强语义特征传到低层高分辨率特征上,使每一层金字塔都既有较强语义,又有较高分辨率。
2. 多层特征
2.1. 浅层特征和深层特征
在前期,提取图像特征,基本是使用 CNN 网络,CNN 网络通过“卷积+池化”操作,不断下采样图样的特征,这个过程就导致在 CNN 网络的不同层具备了不同的特性:
- 浅层的特征,由于下采样的程度不高,导致分辨率较高,位置细节也较好,但是语义相对较弱,这种特征也就比较适合小目标的检测,前面解决小目标,通常也是使用浅层特征。但是这类浅层特征不适合分类,因为相对而言,对语义的抽象较差;
- 深层的特征,与浅层特征不同,深层特征相当于是对特征的高度聚合,这就使得语义很强,感受野也很大,但是,由于是高度的聚合,这就导致分辨率很低,对小目标不够友好。
这就是为什么很多的目标检测算法会综合设用浅层特征和深层特征。
2.2. 两种特征的使用方法
这两种特征的特点已经描述了,那么该如何使用这两种特征呢?一般对于特征会有如下的使用方法:
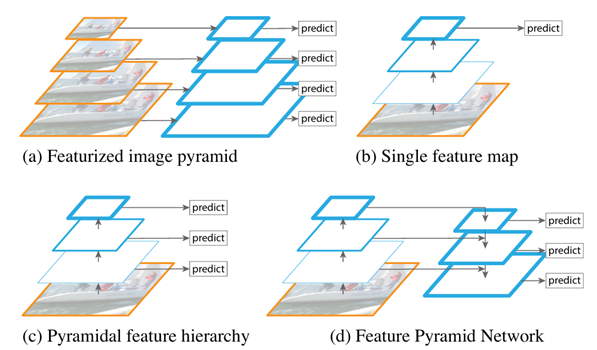
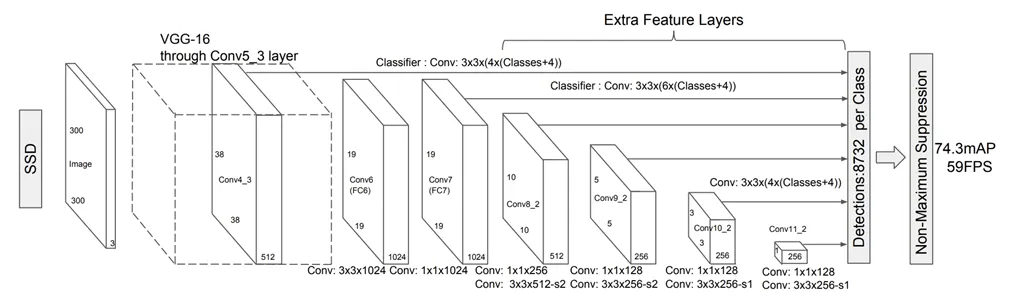
其中,图中 a 是图像金字塔,通过对原始图像的缩放,形成不同尺度的图像,每个尺度单独通过 CNN 的计算,这种方式最大的问题是计算的开销和存储的开销;图中 b 是一般的形式,也就是所谓的单层特征,下游在使用时,只使用最后一层的特征层,这种方式最大的问题时对小目标并不友好;图中 c 是多尺度的方式,在不同深度层直接使用,这种方式最大的问题是浅层并没有克服掉语义弱的缺陷,这个正是 SSD 算法[4]中使用的方式,如下图所示:
最后一种,也就是图 d,这便是 FPN 的方式,在这种方式中,同时有横向的连接,同时在不同层之间还存在着自顶向下的连接,通过高层的强语义特征增强低层的语义特征。
3. 深入理解 FPN
3.1. FPN 的整体结构
以 ResNet 为骨干网络为例,输入图像经过 ResNet,自底向上分别得到 4 个语义特征层:
- ,Stride 为 4,通道数为 256
- ,Stride 为 8,通道数为 512
- ,Stride 为 16,通道数为 1024
- ,Stride 为 32,通道数为 2048
FPN 中对这 4 个语义特征层的操作包括横向连接和自顶向下的连接:其中,横向连接是用 的卷积统一通道数,例如都设为 256,得到了统一通道数的语义特征层;再对这些语义特征层自顶向下连接,这个过程首先需要使用上采样操作,使得 Stride 相等,再与下一层横向连接的特征相加,具体过程如下图所示:
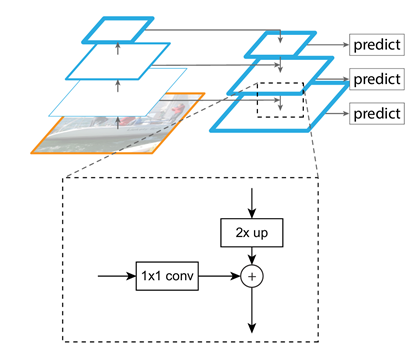
这样便得到了融合后的 4 个特征层,一般会对融合后的结果再经过 的卷积操作,得到 。接下来,我们仔细分析下横向连接和自顶向下连接。
3.2. 上采样
这里还有一个值得关注的地方就是上采样,在参考文献[1]中使用的是最近邻上采样(Nearest Neighbor Upsampling),最近邻上采样最大的有点就是:无参数、计算简单。那么最近邻上采样是如何操作的呢?
为了描述的方便,我们假设输入特征图为 ,上采样的目标特征图为 ,缩放因子为:
对于输出特征图中的每个位置 ,最近邻上采样会找到输入特征图中离它最近的像素位置:
也就是说,输出像素直接取输入中对应“最近邻”的值(每个通道独立进行)。举个简单的例子,假设输入是一个 的特征图,我们希望进行 2 倍最近邻上采样,输出 的特征图,具体的过程如下图所示:
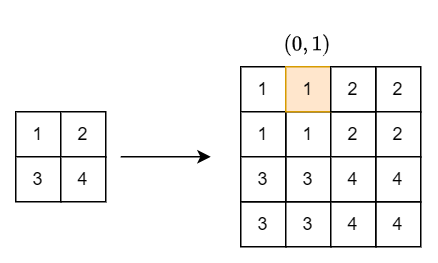
我们以 特征图中的 为例,首先,我们的缩放因子为 ,对于位置 ,我们先计算其输入位置,根据上面的公式,可得到:
其中,,因此,,所以就有了 ,其他的值类推。当然,在 Pytorch 中直接使用 F.interpolate(P5, scale_factor=2, mode='nearest') 即可实现最近邻上采样。
4. 总结
FPN 是 CNN 网络的一个重要模块,通常伴随着一个具体任务存在,如目标检测。FPN 的核心是对多个语义特征层采用横向连接和自顶向下的连接,这样简单的操作就能解决目标检测中的多尺度问题,让浅层特征获得更强的语义,让高层特征保留多尺度表达。
参考文献
[1] Lin T Y, Dollár P, Girshick R, et al. Feature pyramid networks for object detection[C]//2017 IEEE conference on computer vision and pattern recognition (CVPR). Ieee, 2017: 936-944.
[2] Lin T Y, Goyal P, Girshick R, et al. Focal loss for dense object detection[C]//Proceedings of the IEEE international conference on computer vision. 2017: 2980-2988.
[3] Tian Z, Shen C, Chen H, et al. Fcos: Fully convolutional one-stage object detection[C]//2019 IEEE/CVF international conference on computer vision (ICCV). Ieee, 2019: 9626-9635.
[4] Liu W, Anguelov D, Erhan D, et al. Ssd: Single shot multibox detector[C]//European conference on computer vision. Cham: Springer International Publishing, 2016: 21-37.