1. 概述
随着 Transformer 这种基于 Encoder-Decoder 模型框架的大行其道,这股风也成功从 NLP 刮到了 CV 领域,从模型 ViT 到如今的目标检测领域。DETR[1] 是在 2020 年提出的基于 Transformer 的目标检测算法,DETR 是 DEtection TRansformer 的简写,全称是 End-to-End Object Detection with Transformer。
那这个算法相比较前辈们(如多阶段的 Faster R-CNN[2],单阶段的 YOLO[3] 及 SSD[4])有什么优势呢?主要有这样几点优势:
- 端到端的训练和推理。DETR 中简化了目标检测流程,去除了锚框 Anchor 以及非极大值抑制 NMS 的操作,真正实现了端到端的训练,因为锚框或者非极大抑制中还是存在超参数的选择;
- 全局的建模推理能力。得益于 Transformer 架构的全局建模能力,DETR 能够更有效的处理图像的全局信息。
作为 Transformer 框架在目标检测任务下的开创之作,下面就算法的结构,详细介绍下模型的训练以及推理的整个过程。
2. DETR 算法的基本原理
2.1. Transformer 框架
Transformer[5] 网络是大模型的基础,Transformer 网络由多层编码器和解码器堆叠而成,Transformer 的网络结构如下图所示:
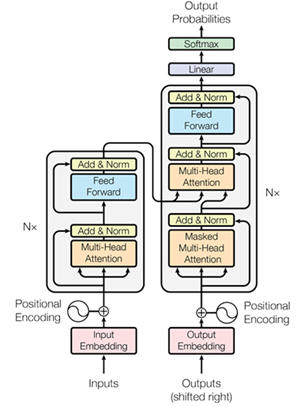
在 Transformer 网络结构中,编码器和解码器都是由多头注意力和前馈网络模块组成,在多头注意力机制中,最重要的是注意力的计算,其一般化的计算公式为:
其中 分别是查询、键、值向量。前馈网络通常由两个线性层和非线性激活组成。
在 Transformer 网络结构中共包含了三种类型的 Attention:
- Self-Attention:在 Transformer 的编码器部分,其中 均来自于编码器部分的输入;
- Masked Self-Attention:在 Transformer 的解码器部分,其中 均来自于解码器部分的输入,与 Self-Attent 不同的是,Masked Self-Attention 并不能看到所有的文本,这个在后面的计算过程部分会详细介绍到;
- Cross-Attention:这是 Transformer 的编码器和解码器结合的部分,其中 来自于解码器的输入,而 来自于编码器的输出;
2.2. DETR 的网络结构
站在写文章的现如今回头来看 DETR 的网络结构,略显有点格格不入,但放在当时,也是一种利用 Transformer 框架处理图像的一种思路,我们直接上 DETR 的网络结构,如下图所示:
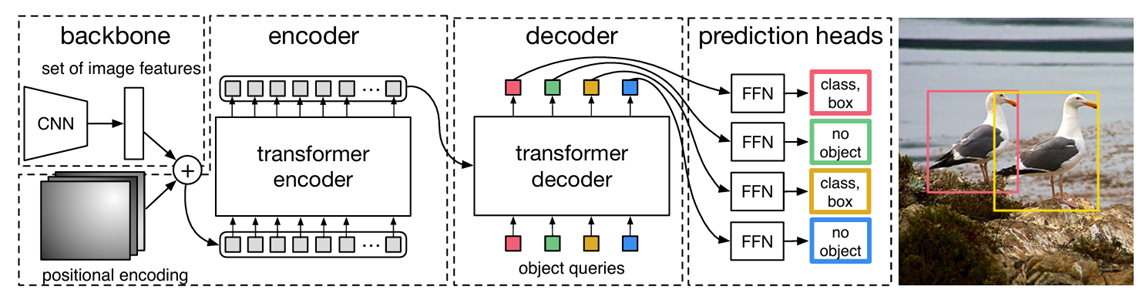
在 DETR 中,假设原始图像为 ,通过一个 CNN 网络得到了图像的语义特征,假设语义特征为 ,其中, 为通道数,如在参考文献[1]中使用的 。这个语义特征也不能直接输入到 Transformer 框架中,因为在 Transformer 框架中,其输入是一个个 Token(也就是按照某种规则切分的子词)的 Embedding,因此需要对语义特征为 做转换,转换的方式如下:
- 先经过 的卷积,将通道数从 降到 ,通常 ,空间维度的变化为:
- 拉平空间维度 ,此时空间维度的变化为:
- 最后转换序列格式,也就是:
这时候就可以输入到 Transformer 中了,相当于有 个 Token,每个 Token 的维度是 。但是,需要注意的是,DETR 中的 Transformer 与标准的 Transformer 存在一些不同,先看一下 DETR 中的 Transformer 结构,如下图所示:
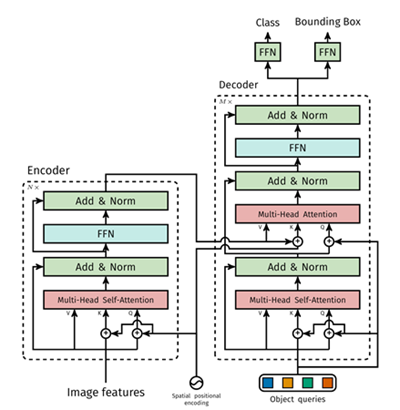
最大的不同是在 Decoder 中,标准的 Transformer 采用的是 Masked Multi-Head Attention,DETR 中采用的是 Multi-Head Self-Attention。我们来回顾下,在标准的 Tranformer 中,Decoder 阶段采用的是自回归的方式,也就是先预测第 1 个元素,再把第 1 个元素作为输入去预测第 2 个,再把前两个作为输入预测第 3 个,以此类推,生成完整的序列,这个过程可以用下面的数学形式表示:
这是一个串形的生成过程,后面的输出依赖于前面的输出。检测出的边框,更多的需要建模全局之间的关系,并没有明确的先后关系。那么 DETR 中是如何做的呢?
在 DETR 中,直接输入 个 object queries,其中每一个 query 都是一个可学习的向量,一次性全部输入到 Decoder 中,同时将标准 Transformer 中的 Masked Multi-Head Attention 改成标准的
Multi-Head Self-Attention,这样就能同时对 个 输入向量建模,经过 Transformer 的 Decoder 之后,输出 的一批 object query 的向量。其中, 为 object queries 的数量,通常是 100, 为向量维度,通常是 256。最后,再经过两个预测头 FFN ,得到最终的检测预测,如下:
- 分类头,得到 个类别的概率,其中, 为类别数, 是增加了一个 no-object 类
- 回归头,得到 个预测框的坐标,其中,每个预测框的归一化坐标
3. 损失函数
通过上面对 DETR 模型的分析,我们知道对于一张图片,DETR 模型会输出个不同的 Bounding Box,那么我们如何评估这个 Bounding Box的效果的好坏呢?这个结果没有顺序,就像一个集合,因此也被称为集合预测(Set Prediction)。
回顾一下 Fastet R-CNN 算法[2],由于其是 two-stage 算法,在第一阶段,先在语义特征层中的每一个 cell 位置上,以该 cell 为中心在原图上生成不同大小和宽高的锚框 Anchor,后续的所操作都是在这系列 Anchor 上做回归和分类,Anchor 的生成过程如下图所示:
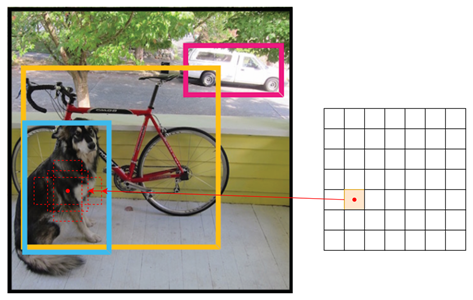
我们注意到每一个 Anchor 在 CNN 中已经被赋予了位置信息,同时通过 Anchor 与 Ground Truth 之间的 IoU 就能确定哪些 Anchor 负责对应的 Ground Truth。
但是在 DETR 中却没有了这样的位置信息,预测结果变成了一系列的集合。在 DETR 算法中的策略是对生成的 个 Bounding Box 采用最优二部图匹配,采用的方法就是匈牙利匹配算法(Hungarian Algorithm),简单来说就是将生成的 个 Bounding Box 作为一个集合,Ground Truth 作为另一个集合(这里需要用“背景”类别将 Ground Truth 扩展到 个),我们需要寻找到 Bounding Box 的集合与 Ground Truth 的集合之间的一对一匹配,以使得代价最小,匹配的关系如下图所示:
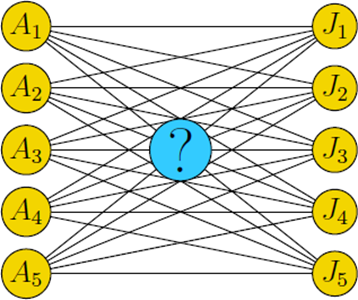
在 DETR 中,匹配器通常直接调用 scipy.optimize.linear_sum_assignment 来求解,对于更多的匈牙利匹配算法相关的内容,可以参见参考文献[6]。当然,上面提到代价为:
其中, 是一个 bool 函数,当 时为 ,否则为 。 是第 个物体的类别标签。 是与第 个目标匹配的 Bounding Box 的 index。 表示 DETR 模型预测的第 个预测的 Bounding Box 的类别为 的概率。 和 分别是第 个目标的位置的 Ground Truth 的坐标和预测的 Bounding Box 的坐标。 是两个矩形框之间的误差,下面我们还会介绍到。在匈牙利匹配算法中,希望找到一对一的匹配,使得上述的代码最小:
匹配完成后,就能为每一个 Ground Truth 匹配到对应的预测值,实现了一对一的匹配,这样就能像 Faster R-CNN 中一样定义模型的损失函数,损失函数为:
其中, 为分类项的损失, 为边界框的损失,具体为:
其中, 指的是 GIoU 损失,通常写为 。参考文献[1]中使用 。
4. 总结
DETR 算法将 Transformer 引入到目标检测中,但是缺失了预测边框与 Ground Truth 之间的对应关系,在 DETR 中,将目标检测视为集合预测问题,并利用 Transformer 的编码器-解码器架构和基于集合的全局损失函数,从而简化了检测流程并去除了传统组件如非极大值抑制和锚框生成,相比较于之前的 Faster R-CNN 以及 YOLO 等算法,DETR 已经在端到端这条路上更近了一步,无需设计 Anchor 以及 NMS,得益于 Transformer 架构,DETR 能够更有效的捕捉整个图像的全局信息。
参考文献
[1] Carion N, Massa F, Synnaeve G, et al. End-to-end object detection with transformers[C]//European conference on computer vision. Cham: Springer International Publishing, 2020: 213-229.
[2] Ren S, He K, Girshick R, et al. Faster r-cnn: Towards real-time object detection with region proposal networks[J]. Advances in neural information processing systems, 2015, 28.
[3] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.
[4] Liu W, Anguelov D, Erhan D, et al. Ssd: Single shot multibox detector[C]//European conference on computer vision. Cham: Springer International Publishing, 2016: 21-37.
[5] Vaswani A , Shazeer N , Parmar N ,et al.Attention Is All You Need[J].arXiv, 2017.DOI:10.48550/arXiv.1706.03762.