1. 概述
CLIP[1] 模型是 OpenAI 在 2021 年初发布的用于匹配图像和文本的预训练神经网络模型,全称是 Contrastive Language-Image Pre-Training。为什么 CLIP 值得再次研究,不仅仅是因为 CLIP 算法本身的设计思想,更是因为研究人员一直致力于得到更好的预训练模型。我们知道,要想训练好一个模型,需要大量的数据,如果一直依赖于标注数据,那么需要大量人力,财力去标注数据,因此,研究人员一直设法找到一种能够得到预训练模型的方法。回顾整个预训练的发展过程,大致分为这样的几个阶段:
- 图像分类,在这个阶段通过构建大量的人工标注数据集,如 ResNet[2] 算法等在 ImageNet 数据集上完成训练。通过在标注数据集上的训练,让模型具备图像的语义表示能力;
- 通用视觉表征训练,上一个阶段,毕竟还需要人工的标注,在通用视觉表征训练阶段,则是希望模型能够通过自监督等方式,完成学习,减少对人工标注的依赖,这个阶段,出现诸如 MoCo[3]、SimCLR[4]、DINO[5] 等算法;
上面两个阶段,都在解决一个问题:图像的语义表征。为了应对下游的任务,如图像分类(我们这里假设这个类别并不在原先的预训练类别中),此时需要结合已经得到的语义表征,对模型进行微调。有没有一种方法,能真正实现零样本的分类?这就是以 CLIP 为代表的视觉-语言联合预训练阶段要完成的事情,简单来说就是:利用大规模图文配对数据,让模型在共享语义空间中理解图像与文本的对应关系,从而实现零样本分类和图文检索。
2. CLIP 算法原理
CLIP 是直接通过对图文配对数据的训练,在共享的语义空间中学会图像与文本之间的对应关系,要实现这昂的学习过程,我们先看一下 CLIP 的网络结构。
2.1. CLIP 的网络结构
CLIP 的网络结构如下所示:
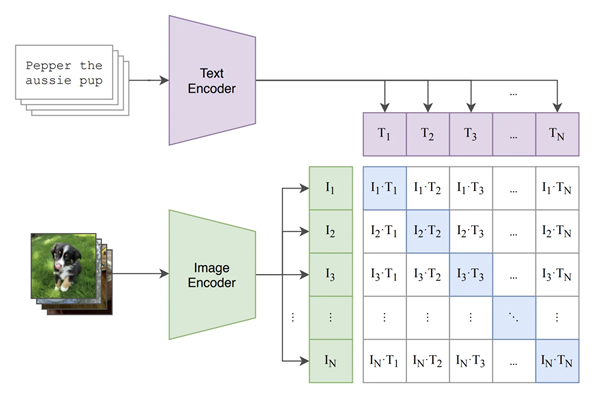
CLIP 使用双编码器(Dual Encoder)结构,包含两个相互独立、但通过训练目标共同优化的编码器,其中,图像编码器 Image Encoder 的作用是将图像映射为视觉特征,文本编码器 Text Encoder 的作用是将文本映射为语言特征。完成编码后,将特征投影到同一个维度的语义空间中。
对于图像编码器部分,在参考文献[1]中,CLIP 算法的图像编码器部分分别使用了 ResNet[2] 和 Vision Transformer[6] 两种图像编码器:
- ResNet 中图像经过卷积网络提取特征,最终使用注意力池化机制汇总视觉信息,再映射到共享的图文向量空间;
- ViT 中图像首先被切分成多个 Patch,每个 Patch 转换成一个向量,经过 Transformer 建模不同区域之间的关系,最后提取全局图像表示。
得到图像的语义特征 $h_I $ 后,再经过一组投影映射后,得到映射后的特征 。
对于文本编码器部分,CLIP 的文本编码器采用 Transformer 架构,得到文本的语义特征 ,再经过一组投影映射后,得到映射后的特征 。
图像语义特征和文本语义特征分别经过投影映射后,将两个编码器原本不同维度的特征,转换到一个可直接比较的公共空间中,为了能够实现比较,通常还需要对投影后的向量进行 L2 归一化:
此时,图像和文本的相似度就可以通过点积 计算,由于两个向量的模长都是 ,即 ,所以点积等于余弦相似度,即 。相似度越大,表示模型认为这对图像与文本在语义上越匹配。
2.2. 对比学习损失函数
上面介绍了 CLIP 的整个网络结构,接下来就是要训练号这个模型,损失函数的设计是 CLIP 算法成功的关键,在 CLIP 中,使用图像—文本对比学习(Contrastive Learning),通过一个批次内的匹配关系,同时训练图像编码器和文本编码器。
首先来看下训练数据,上文中也提到了 CLIP 中使用的是图像-文本对 ,网络上存在大量的图片以及图片这样的描述数据,这就构成了训练数据,完全不需要人工标注。正样本有了,那么负样本呢?这个很好解决,批次 Batch 内其他的任意组合,如 就构成了负样本。
假设对于一个批次的图像向量和文本向量,分别为: 和 ,批次 Batch 的大小为,得到两者的相似矩阵:
其中,向量 和 已进行 L2 归一化, 是温度参数(temperature)。最终得到了如下矩阵:
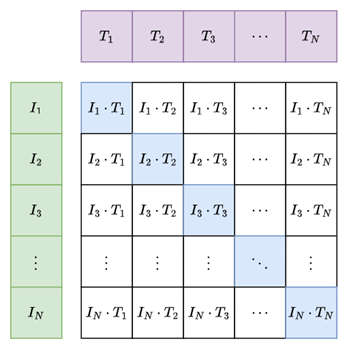
其中,第 行第 列表示的是第 个图片和第 个文本对之间的相似度。通常用 Softmax 函数,将相似度转换成一个概率分布,公式如下:
最终,我们能得到所有的图像到文本的损失函数,如下:
有了这个损失,会使得对于指定的图像,能在候选文本中找到最好的,仅仅训练图像到文本还不够。在 CLIP 算法中同时使用文本到图像的损失函数,如下:
综合这两部分的损失函数,就构成了 CLIP 最终的损失函数,如下:
这也称为对称对比学习。
2.3. 如何使用
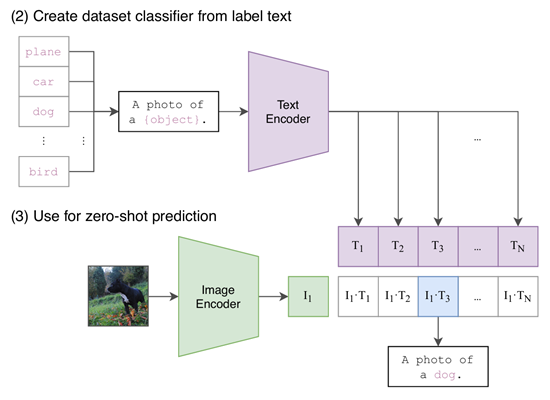
模型训练完成后,我们能得到两个模型,分别是文本编码器 Text Encoder 和图片编码器 Image Encoder。以上面的分类为例,实现零样本分类(Zero-shot Classification)是 CLIP 最基本的能力之一。在 CLIP 的推理阶段,首先对所有的文本构建候选的类别描述,如下:
通过文本编码器对所有的类别描述生成文本向量:
对图像 使用图像编码器生成图像向量:
计算图像与每个候选文本的相似度得分:
取得分最高的文本为预测的类别:
上述过程如下图所示:
由于 CLIP 能将文本和图像映射到一个共享的空间中,因此,除了上述的零样本分类外,还能处理以下的一些工作:
- 文本到图像检索,即给定一段文本,找到最匹配该文本描述的图片
- 图像到文本检索,即给定一张图片,在大量文本描述中找到最匹配的描述
- 图像相似性与语义筛选,即通过图像嵌入检索语义相近的图片
3. 总结
CLIP 利用图像编码器和文本编码器将图片-文本对映射到一个共享的语义空间中,并通过对比学习,同时调整两个编码器的参数,使得在同一个语义空间中,匹配的图片-文本对之间的相似度高,不匹配的图片-文本对之间的相似度尽量变差,以此得到两个编码器。有了这两个编码器之后,可以完成很多基于相似度计算的下游任务,同时,也为后续的模型发展提供了一些思路,成为发展史上很重要的一环。
参考文献
[1] Radford A, Kim J W, Hallacy C, et al. Learning transferable visual models from natural language supervision[C]//International conference on machine learning. PmLR, 2021: 8748-8763.
[2] He K, Zhang X, Ren S, et al. Deep residual learning for image recognition[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 770-778.
[3] He K, Fan H, Wu Y, et al. Momentum contrast for unsupervised visual representation learning[C]//2020 IEEE/CVF conference on computer vision and pattern recognition (CVPR). IEEE, 2020: 9726-9735.
[4] Chen T, Kornblith S, Norouzi M, et al. A simple framework for contrastive learning of visual representations[C]//International conference on machine learning. PmLR, 2020: 1597-1607.
[5] Caron M, Touvron H, Misra I, et al. Emerging properties in self-supervised vision transformers[C]//2021 IEEE/CVF international conference on computer vision (ICCV). IEEE, 2021: 9630-9640.
[6] Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[J]. arXiv preprint arXiv:2010.11929, 2020.