1. 概述
在生成式模型之前,传统的目标检测算法在做的一件事概括起来就是通过模型生成预测框,并将生成的预测框和真实框之间的误差定义成可优化的目标,不断优化模型,使得模型生成的预测框更加准确。根据不同的分类标准,可将算法分成不同的类型:
- 是否包含多阶段,分为 one-stage (如 YOLO[1],SSD[2] 等)和 two-stage(如 Faster R-CNN[3])
- 是否需要 Anchor,分为 Anchor-Based(如 Faster R-CNN)和 Anchor-Free(如 SSD)
以上还是基于 CNN 的目标检测算法,随着 Transformer[4] 架构在文本领域的发展,DETR[5] 算法也是成功地将 Transformer 引入到目标检测领域,创造性地提出了基于二部图匹配的训练方式,将目标检测问题转换成集合预测问题,避开了 Anchor 的生成以及繁杂的后处理流程,如 NMS 等操作。随着生成式模型的大行其道,目标检测领域也再拥抱新的方向。Pix2Seq[6] 就是其中非常有代表性的目标检测工作之一,它提出了一种不同于 Faster R-CNN、YOLO、RetinaNet[7] 等传统检测器,将目标检测看作一个序列生成问题,直接使用类似语言模型的方式生成目标的位置和类别。
2. Pix2Seq 算法原理
Pix2Seq 的基本结构也是基于 Transformer 框架,与 DETR 不同的是,在 DETR 中,其实还是一种编码器的方式;而在 Pix2Seq 中,完全把目标检测看作一个序列生成问题,直接生成最终目标的位置和类别。
2.1. Transformer 框架
Transformer[4] 网络是大模型的基础,Transformer 网络由多层编码器和解码器堆叠而成,Transformer 的网络结构如下图所示:
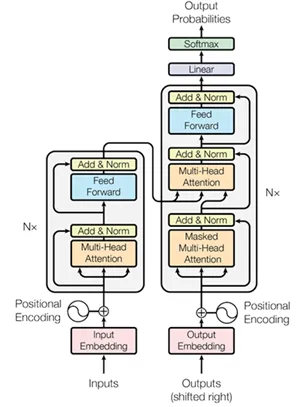
在 Transformer 网络结构中,编码器和解码器都是由多头注意力和前馈网络模块组成,在多头注意力机制中,最重要的是注意力的计算,其一般化的计算公式为:
其中 分别是查询、键、值向量。前馈网络通常由两个线性层和非线性激活组成。
在 Transformer 网络结构中共包含了三种类型的 Attention:
- Self-Attention:在 Transformer 的编码器部分,其中 均来自于编码器部分的输入;
- Masked Self-Attention:在 Transformer 的解码器部分,其中 均来自于解码器部分的输入,与 Self-Attent 不同的是,Masked Self-Attention 并不能看到所有的文本,这个在后面的计算过程部分会详细介绍到;
- Cross-Attention:这是 Transformer 的编码器和解码器结合的部分,其中 来自于解码器的输入,而 来自于编码器的输出;
2.2. Pix2Seq 的模型结构
Pix2Seq 的模型结构与 DETR 算法基本一致,所不同的是 Transformer 中的 Decoder 部分,在 Pix2Seq 中是如上标准的 Decoder,而在 DETR 中则对其中的 Masked Self-Attention 做了修改。Pix2Seq 的框架结构如下图所示:
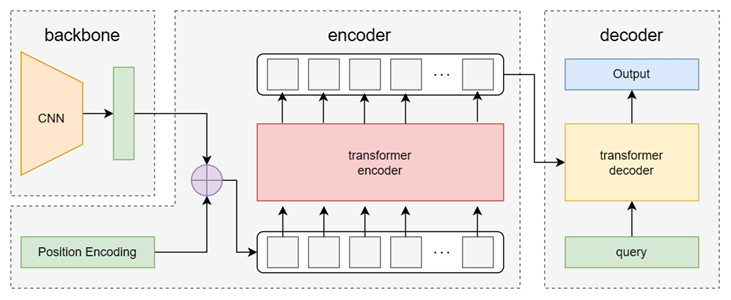
Pix2Seq 的框架结构中主要可以分为三个部分,分别是 backbone,encoder 和 decoder。其中 backbone 部分用于图像语义特征的提取,这个部分与 DETR 中是一致的,既可以使用 ResNet 作为 Backbone,也可以使用基于 Transformer 的 Vit 模型。得到图像的语义特征后,作为输入特征输入到 Transformer 的 encoder 中。
后面是与 DETR 区别比较大的地方,Pix2Seq 不再要求模型直接输出一组固定结构的检测结果,而是把每个目标编码成一串离散 Token。坐标和类别都被转换成离散 Token。模型逐个预测 Token,前面已经生成的 Token 会作为后续预测的条件。目标检测可以写成一个条件概率建模问题:
其中: 是输入图像, 是整个目标检测序列, 是当前 Token 之前已经生成的序列, 表示的是给定图像和历史 Token,预测下一个 Token 的概率。模型不再直接回归一组连续坐标,而是把坐标与类别转化为离散 Token,通过自回归生成完成检测。这里很重要的一点就是目标编码成一串离散 Token。
2.3. 连续目标的离散化
要想利用自回归生成,对于连续目标,一种办法就是对这些目标坐标数值离散化,转化为像文字一样的离散的 Token,这也是 Pix2Seq 算法不同于以往的目标检测算法的关键点。在传统的目标检测中,真实的边界框通常使用连续数值表示,如:,其中 为边界框左上角的坐标, 为边界框右下角的坐标,如下图所示:
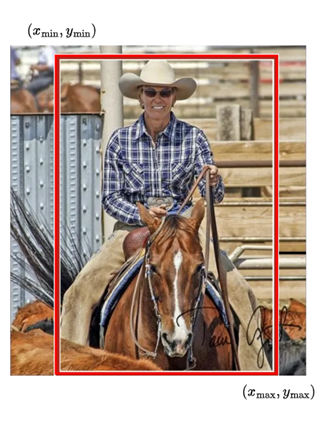
为了将边框坐标转换成离散的 Token,在参考文献[6]中采用均匀量化(Uniform Quantization),将坐标映射到有限数量的离散区间。具体的操作步骤为:
第一步,把边框坐标归一化到 。假设输入图像的宽为 ,高为 ,对上面边框坐标归一化为:
其中:
归一化之后,边框坐标都处于 到 的范围内。
第二步,将归一化后的边框坐标量化为离散的整数,采用的公式为:
其中, 是离散的 bins 的数量, 表示的是上述的归一化的坐标,最终输出的整数的范围为 到 。这样便得到了最终的坐标的离散化 Token。在训练的时候,每个目标被编码成 个离散的 Token,如下所示:
其中, 是类别的 token。如果一个图片中存在多个目标,就把各个目标的 个 Token 依次串接起来,最后添加一个 EOS Token,表示结束。
2.4. 目标的顺序问题
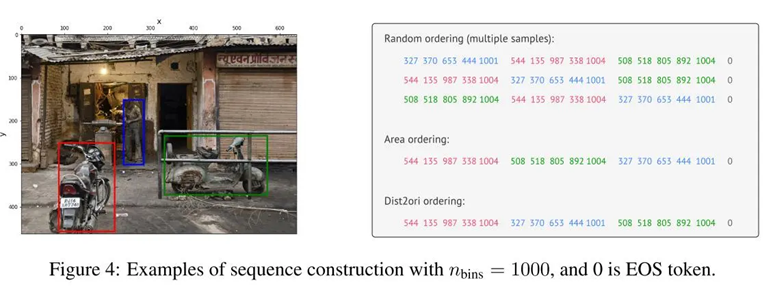
这是一个容易忽略、但非常重要的问题。当图片中存在多个目标,我们把各个目标的个 Token 依次串接起来,最后添加一个 EOS Token,那么以什么样的顺序组织呢?本身来说,目标检测的输出是一个集合,正如 DETR 中描述的一样,集合天然是没有顺序的,但是在自回归模型中,生成的过程是有顺序的序列:
在 Pix2Seq 中,提出了一个关键的设计,就是在训练时,随机打乱图像中各个目标的排列顺序,以此让模型减少对某一种排列的依赖,其过程如下图所示:
3. 训练和推理
3.1. 训练
有了上面的准备,这就可以准备模型的训练,很好理解,训练时,模型要学习的是:
整体目标是最大化真实目标序列的条件似然,等价于最小化 Token 级别的交叉熵损失:
其中, 是真实标注对应的 Token。
为了在训练的过程中能够提升模型生成的检测框准确性,在参考文献[6]中也是设计了一些策略,主要有:
- 图像数据增强,这个也是 CV 中的常规操作,包括:随机尺度变换,随机裁剪以及颜色扰动等等;
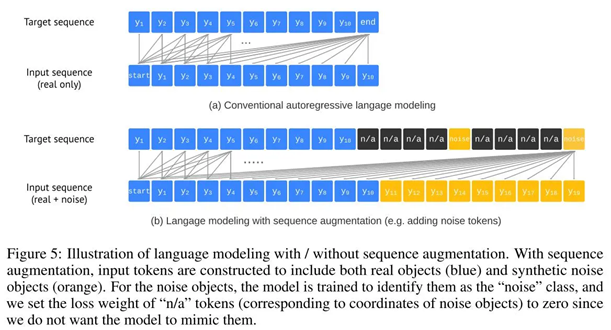
- 序列数据增强,这是 Pix2Seq 中比较有特色的数据增强方法,简单来说就是人为构造带噪声的目标框序列,让模型学会识别并拒绝错误的检测结果。如:对真实目标框添加噪声,对已有的真实目标框随机缩放或平移,构造一个与真实框相似、但位置或大小不准确的候选框。或者生成完全随机的目标框,随机生成一个边界框,并为它随机关联一个类别标签。如下图所示:
- 第三种也是上面提到了随机打乱目标顺序,提升模型的生成能力;
- 还有一个是大家容易忽略的,在利用自回归预测坐标时,坐标之间并不是完全独立的,可以利用图像特征和已经生成的坐标,学习目标框各个坐标之间的统计关系。
3.2. 推理
推理的时候,对于输入图像 ,开始生成目标序列,预测的序列中按照 个 Token 切分(其中前 个为坐标的 Token,最后一个是类别的 Token),直到遇到 EOS 的 Token。
注意,在推理阶段,还有一个 Token 的坐标还原过程,假设 Token 为 ,其量化还原过程为:
最后再乘以图像的宽或者高,就得到近似的原始像素坐标。
4. 总结
目标检测从最初的基于候选框与密集预测开始,通过在预设的位置或者候选框上预测类别和边界框,这个阶段,代表性的算法有 Faster R-CNN、YOLO、RetinaNet 等;DETR 摒弃了这一套的思路,基于 Transformer 框架,将目标检测问题转换成集合预测的问题,在整个检测过程中,终于没有了繁杂的后处理流程,而且也不再需要 Anchor 的操作;Pix2Seq 算法进一步将目标检测问题转换成序列生成问题,将目标集合序列化,通过自回归模型生成每个目标的位置与类别,让语言模型直接输出连续边界框,而是先把边界框和类别编码成离散序列,再用条件自回归建模来完成检测,也为后来的视觉生成式建模提供了一种重要思路,模型可以通过生成结构化 token 来完成感知任务,而不一定需要为每个任务单独设计一套专用输出头,已完成特定的任务。
参考文献
[1] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.
[2] Liu W, Anguelov D, Erhan D, et al. Ssd: Single shot multibox detector[C]//European conference on computer vision. Cham: Springer International Publishing, 2016: 21-37.
[3] Faster r-cnn: Towards real-time object detection with region proposal networks[J]. Advances in neural information processing systems, 2015, 28.
[4] Vaswani A , Shazeer N , Parmar N ,et al.Attention Is All You Need[J].arXiv, 2017.DOI:10.48550/arXiv.1706.03762.
[5] Carion N, Massa F, Synnaeve G, et al. End-to-end object detection with transformers[C]//European conference on computer vision. Cham: Springer International Publishing, 2020: 213-229.
[6] Chen T, Saxena S, Li L, et al. Pix2seq: A language modeling framework for object detection[J]. arXiv preprint arXiv:2109.10852, 2021.
[7] Lin T Y, Goyal P, Girshick R, et al. Focal loss for dense object detection[C]//Proceedings of the IEEE international conference on computer vision. 2017: 2980-2988.