1. 概述
ViT[1] 算法首次实现了利用 Transformer[2] 处理视觉问题,更具体点是 Transformer 结构中的 Encoder 部分,纵观 ViT 的整个算法流程,我们不难发现,ViT 算法中是尽量保留 Transformer 中 Encoder 的完整结构,将输入的图像数据处理成 Encoder 需要的格式,这一点虽使得 Encoder 能够处理图像问题了,但是毕竟这个 Encoder 架构是针对文本的特点设计的结构。
这一步算是将 Transformer 架构应用在图像特征提取领域,但是 Transformer 的整个结构是为了文本设计的,很多设计逻辑是结合了文本的特点。研究者们的下一步行动就是要针对图像的特征,对 Encoder 的结构做特定的优化,Swin Transformer[3] 就是其中的一个优化算法,在 Swin Transformer 中,图像转成 Token 之后,并不是像 ViT 中那样做全局的注意力,而是在局部窗口中计算注意力,并通过不断移动窗口,让不同窗口之间也能交换信息;同时,在 Swin Transformer 中也采用类似 CNN 的分层的结构,逐步降低特征图的分辨率,这一系列的优化,使得 Swin Tranformer 处理目标检测、图像分割等任务时,更加得心应手。
2. Swin Transformer 算法原理
2.1. ViT 的基本原理
首先,我们先来回顾下 ViT 的基本原理,ViT 的结构如下所示:
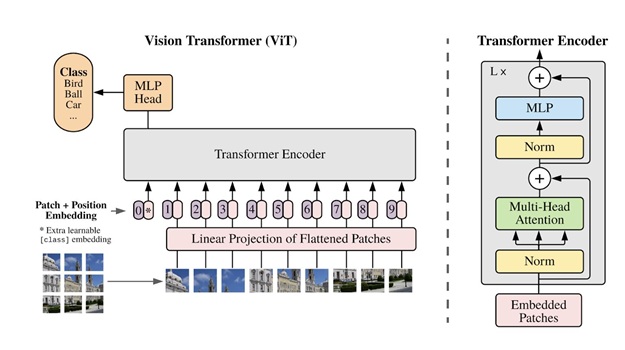
对于一张图片,首先需要将图片切成 Patch,假设输入一张 的 RGB 图片,每个 Patch 的大小为 ,则所有的 Patch 数量为:
接下来对每个 Patch 做线性映射,每个 Patch 被映射成一个固定维度的向量,如 768 维,这是时候,原始的图片被转换成 Transformer Encoder 的输入 ,即一张二维图像变成了长度为 196 的 Token 序列,每个 Token 的维度是 768。
这样就将输入的图像处理成和文本一样的序列结构,下面就可以像处理文本一样,利用标准的 Transformer Encoder 的流程处理图像,流程包括增加位置信息 Position Embedding,多头注意力 Multi-Head Self-Attention,前馈网络 MLP 等等。其中,Self-Attention 的计算方法如下:
其中,,在 Attention 的计算中,196 个 Token 都参与相互计算,回归到图像中,也就是每一个 Patch 会关注到图像中所有其他的 Patch,用一个图来表示:
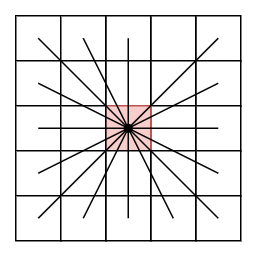
这无疑会带来很多的计算量,如上图像转换完成后是 196 个 Token,计算的时间复杂度就变成 。另一方面,完整的 ViT 中是由多个 Transformer Encoder Block 堆叠而成的,然而在 Block 与 Block 之间,始终保持的序列长度是不变的,这一点也与传统的 CNN 不一样,在图像中还是需要分层聚合周围的信息。综合来看,在 ViT 中存在两个问题:
- 全局 Self-Attention,如果有 个 Token,注意力的时间复杂度是
- ViT 的特征序列长度保持不变,不能产生多层不同分辨率的特征图
2.2. Swin Transformer 的算法原理
2.2.1. Swin Transformer 的架构
先来看下 Swin Transformer 的整体架构图,如下所示:
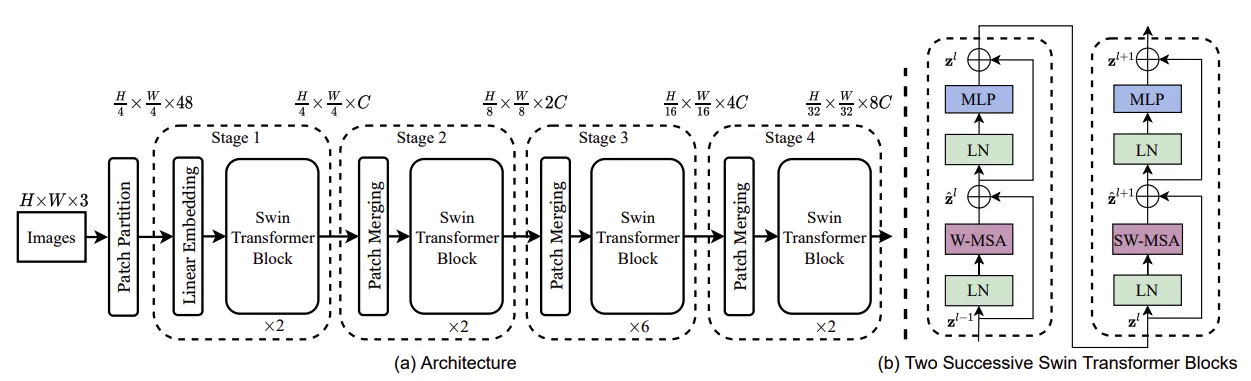
我们来看下 Swin Transformer 的具体过程,与 ViT 一样,对于输入的图像,需要经过如下的几个重要的步骤:
- Path Embedding,这一步的目的是将原图变成特征图,这个与 ViT 中基本一致,不同的是在 Swin 中,切分的块更小(切分成 的小块,而在 ViT 中块的大小为 ),切分完成后,还要对每一个 Patch 做线性映射,目的是将每个 Patch 映射成一个固定维度的向量,实现 Token 化。
- 进入每个 Stage,与 ViT 有所不同的是,每个 Stage 中除了 Swin Transformer Block 之外,有时还会加入 Patch Merging。先来看 Swin Transformer Block,这部分也与标准的 Transformer Encoder 有所不同,每个 Swin Transformer Block 中由两个优化后的 Self-Attention 组成,分别为:W-MSA 和 SW-MSA,这两者的目的是实现在窗口内部做 Self-Attention,降低 ViT 中全局 Self-Attention 的时间复杂度;另一个重要的组件是 Patch Merging,其目的是实现多分辨率的特征图。
接下来,针对每一块的具体的细节将详细介绍。
2.2.2. W-MSA
W-MSA 全称是 Window-based Self-Attention,是对标准 Transformer Encoder 中多头注意力机制 Multi-Head Self-Attention 的优化之一,为了描述这部分,我们假设输入原图的大小为 ,经过 Patch Embedding 之后,假设要将原图切分成 的小块,则共切分成 块 Patch,接下来对每个 Patch 做线性映射,每个 Patch 被映射成一个固定维度的向量,如 96 维(实际上这个操作通过一个卷积操作就可以完成,卷积核大小为 ,Stride 为 4,输出的通道数为 96 维),因此,最终的 Token 数为 。将 个 Token 重新组织成一张 的网格,保留与原始图像的相对位置,如下图:
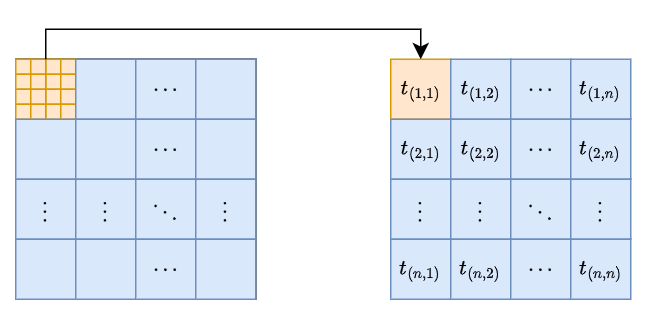
再把这 的 Token 网格划分成窗口,在 Swin Transformer 中,设定窗口大小 ,则 的 Token 网格共可分为 个窗口,如下图所示:
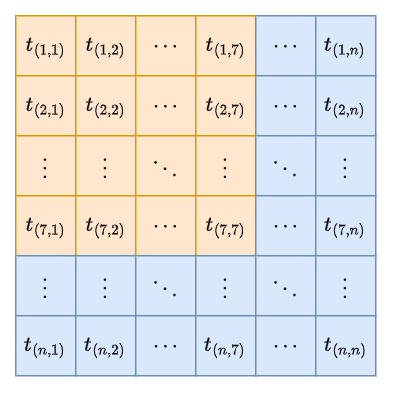
上图中黄色的部分就是一个窗口。W-MSA 就是需要在这每个窗口内部做 Self-Attention,Self-Attention 的计算方法还与上面是一样的:
注意到一点,这里的个窗口在进行 Self-Attention 计算时完全是可以并行的。这是一个关键的步骤,与 ViT 的区别是,在 ViT 中,是将上面所有的 个 Token 排成一排进行 Self-Attention 的操作,而在 Swin 中,Self-Attention 的操作是在每个窗口中,也就是对每个的的 Token 实施 Self-Attention 的计算,这就完成了 W-MSA 的计算,这样能将 Self-Attention 的计算时间复杂度降下来。
2.2.3. Shifted Window Partitioning
单纯依靠 W-MSA 还是不够的,在 Swin Transformer 中还提出了 Shifted Window Partitioning,也就是移位窗口划分,这也是 Swin Transformer 中的核心创新,因为在 W-MSA 中,窗口之间是相互独立的,缺乏了跨窗口的连接,这样会限制其建模能力,尤其是对于图像来说。
再来看下 W-MSA 中的窗口划分,如上设定窗口大小 ,则 的 Token 网格共可分为 个窗口,这是一种完全的非重叠的划分,而在移位窗口划分 SW-MSA 中,采用了将窗口整体平移,使新的窗口跨越上一层的窗口边界。
在参考文献[3] 中,将窗口划分的起始位置偏移 个 像素,其中 是窗口大小,W-MSA 和 SW-MSA 如下图所示:
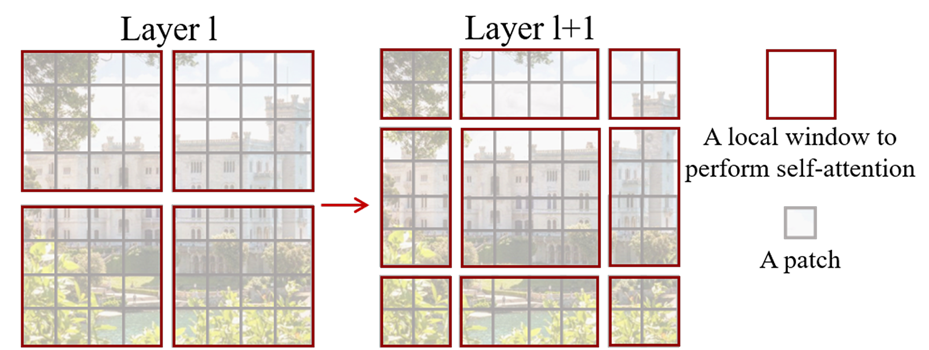
假设在第 层时是采用的 W-MSA,一个 的特征图被划分成 个窗口,每个窗口的大小为 ,也就是 ,在第 层时采用的是 SW-MSA,窗口整体向右下角平移 个像素,也就是 个像素,这个实际就会看到上图中中间的那个 的窗口,但是这样划分出来,虽然实现了第 层中四个窗口的信息跨窗口流动,但是留下了一圈 , 以及 的窗口,这些窗口应该如何操作呢?
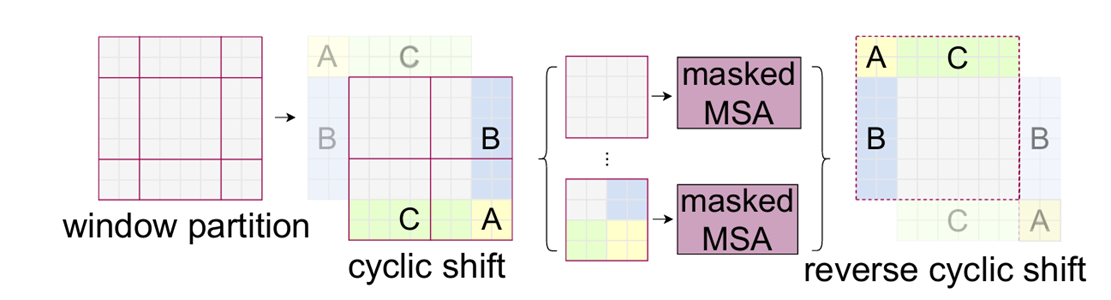
在 Swin Transformer 中提出了一种被称为高效的批量计算(Efficient Batch Computation)的方法,其主要的步骤为:
- Cyclic Shift:即把整个特征图循环移位,通常向上、向左 roll ,对于上面那个图,我们有如下的移位,如下图所示:
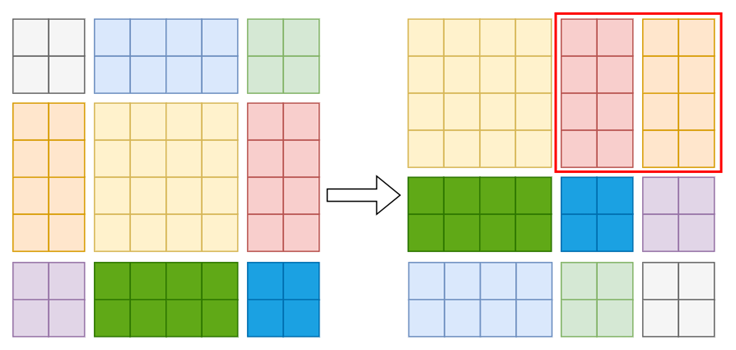
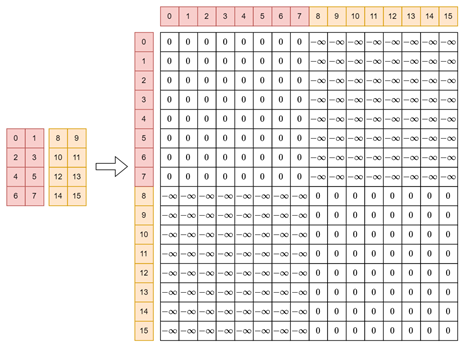
- 这样仍然按常规 切成 4 个规整窗口,批大小不变,但每个 窗口内部可能包含原图中不相邻的子区域,所以要用 Attention Mask 屏蔽掉不该互相注意的子块,以上图中红色框中窗口为例,这个窗口中包含了两个子区域,但是这两个子区域并不是相邻的,Attention Mask 为:
- Attention 算完后,再反向 Cyclic Shift 恢复原空间顺序,以便送入下一个 Block。
以上的步骤如下图所示:
这里的 roll 操作,可以使用 Pytorch 中的
torch.roll函数实现。
2.2.4. Attention 的计算
上面提到在每个窗口内部做 Self-Attention,Self-Attention 的计算方法为:
但是这里有个细节上面没有提及到,在标准的 ViT 中,这里的 是增加了绝对位置编码的,这一点也完全符合标准的 Transformer 框架。
然而,在 Swin Transformer 中,Token 的空间位置会不断的变化,尤其是在 Cyclic Shift 中,因此在 Swin Transformer 的 Self-Attention 中引入了相对位置偏置 Relative Position Bias 的概念,它把窗口内 Token 之间的相对坐标编码进 Attention Score 中,具体的计算方法为:
其中, 就是相对位置偏置, 为一个窗口内的 Token 的数量。
这种相对位置偏置只关心两个 Token 在窗口内的相对位移,与窗口在特征图中的绝对位置无关,因此天然适配 Swin Transformer 的窗口机制。在参考文献[3]中并没有直接学一个 的大矩阵,而是参数化一个更小的偏置表 ,至于为什么是 ?那是因为一个窗口的大小是 ,窗口内任意两个 Token 的相对位移:
每个方向有 种取值,所以相对位置组合共有 种。在实际使用时,根据每对 Token 的 从 中查表,填入 。这样参数量从 降到 。
2.2.5. Patch Merging
我们来到了最后一个部分,也就是 Swin Transformer Block 之间的 Patch Merging,其作用是对上一个 Block 的结果下采样,即让特征图变小、通道变多,通过这种方式构建层次化特征金字塔。具体是如何显示的呢?我们假设第 个Stage 输出的特征图是 ,Patch Merging 的步骤如下:
- 把空间上 邻域的 个 Token 拿出来,在通道维度上拼接,得到 维,也就是特征图变成
- 再通过一个先行层降维到
总结来看,上述过程也就是:
通过上述的操作,特征图越来越小,通道越来越多。这与 CNN 中的下采样的操作类似。
3. 总结
ViT 首次使用 Transformer 处理图像,证明了 Transformer 在视觉领域的可行性,Swin Transformer 则是在 ViT 的基础上,结合了图像的特点,设计了 W-MSA 和 SW-MSA 两种基于窗口的 Attention 计算方法,将 ViT 中基于全局的 Attention 的算法时间复杂度降低,同时,在 Block 之间加入 Patch Merging,对图像特征起到了下采样的作用,总体来看,Swin Transformer 并没有改变 Transformer 的基本原理,而是调整了信息交互范围和特征组织方式,让 Transformer 更适应计算机视觉中的高分辨率输入、多尺度目标以及密集预测任务。
参考文献
[1] Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[J]. arXiv preprint arXiv:2010.11929, 2020.
[2] Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need[J]. Advances in neural information processing systems, 2017, 30.
[3] Liu Z, Lin Y, Cao Y, et al. Swin transformer: Hierarchical vision transformer using shifted windows[C]//2021 IEEE/CVF international conference on computer vision (ICCV). Ieee, 2021: 9992-10002.