1. 概述
YOLO v1[1] 开创了 one-stage 目标检测的先河,但是 YOLO v1 中也存在着很多的问题,回顾 YOLO v1 的算法的整个过程,对于 的图像,经过一系列卷积+池化的操作后,得到 的语义特征层,YOLO v1 的操作也便是在这个语义特征层上展开的。在这个 的语义特征层上,每一个 cell 预测 个 Bounding Box 和 个类别概率,这里面会出现两个问题:
- 第一,每个 cell 只能负责有限数量的候选框,全部的 的语义层,能负责的候选框的数量为:,这就会导致 YOLO v1 的召回率会存在一些问题;
- 第二,在 YOLO v1 中直接预测边框的参数 ,而不是像 Faster R-CNN[2] 中先有一个参考框,再预测相对于参考框的偏移量。这样的学习难度会比较大。
其次是语义层的大小是固定的 ,尺度较为固定,无法同时适应大目标和小目标。针对这些问题,在 2017 年,Joseph Redmon 等人提出了 YOLO 的改进版,民间统称为 YOLO v2[3]。主要的改动包括三个方面:
- 语义特征层的优化
- 增加 Anchor Boxes
- 其他网络结构上的优化
2. 语义特征层
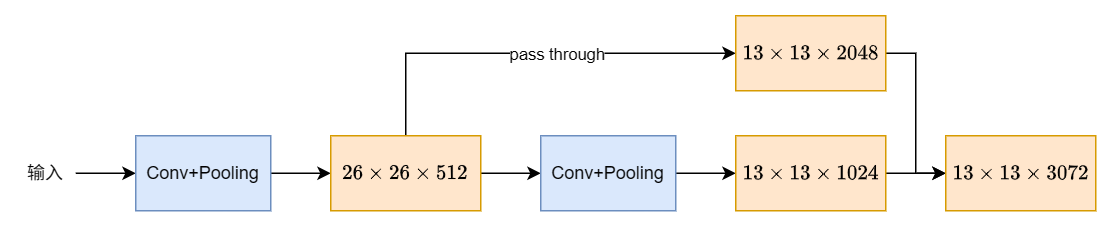
在 YOLO v1 中,对于 的图像,经过一系列卷积+池化的操作后,得到 的语义特征层,使用的是单语义层的特征。而在 YOLO v2 中,语义特征层由两个部分组成:
- 一个是卷积层的 的语义特征层;
- 第二个是从前面拿了一个较高分辨率的 的语义特征层。
将两部分组合在一起,形成最终的 的语义特征层。组合的过程是先将 通过 passthrough layer 转变成 ,这个过程只是一个空间重排,相当于将空间尺寸减半、通道数变成 倍,即:。举个简单的例子,假设现在有一个单通道的数据 ,即 ,最终将其变成 ,这个过程如下图所示:
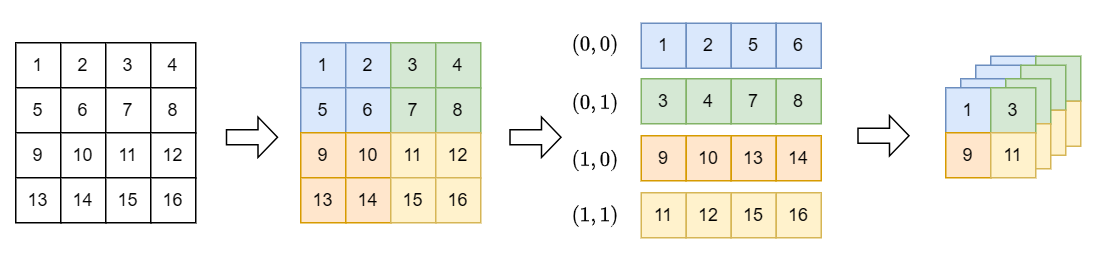
最终,通过通道维度将两个特征层融合在一起,其整个过程如下图所示:
3. Anchor Boxes
这是我认为 YOLO v2 与 YOLO v1 最为重要的差异点了。在 YOLO v1 中,每一个通道的语义特征层的大小为 ,这 $49 $ 个 cell 中的每一个预测 个边界框 ,这严重限制了可召回的边界框的数量。
在 YOLO v2 中,每一个通道的语义特征层的大小为 ,与 YOLO v1 不同的是:
- 首先第一点,在 YOLO v2 中,每一个 cell 预测 个边界框,这一下子从 YOLO v1 的 个预测框增到到 个预测框;
- 第二点,这个预测框的生成逻辑也与 YOLO v1 中有很大的不一样,在 YOLO v1 中直接预测边界框的参数 ,然而直接预测边框参数是较为困难的,在 YOLO v2 中也是借鉴了 Faster R-CNN 中的做法,先有一个参考框,然后再学习相对于参考框的偏移量,这样的学习难度能得到下降,这里的参考框,在 YOLO v2 中称为先验框。
其中,第一点与 YOLO v1 中的逻辑大致相同,只是可预测的数量增多了。重点是第二点,在第二点中,有两个基本问题,第一是先验框是如何得到的;第二是如何学习到相对于先验框的偏移量。
3.1. 先验框
先验框是预先生成的一组边界框,在 Faster R-CNN 中,anchor 是按照特定的尺寸和长宽比手动生成的,但是,这种设计方法有个问题就是不同的数据集的目标大小、形状分布都不一样,这样的设计不一定适合所有的情形。与 Faster R-CNN 不同的是,在 YOLO v2 中,直接统计训练集中 Ground Truth 框的宽高分布,用聚类找出最具代表性的几组宽高,以此作为先验框,一般采用 K-Means 聚类方法。具体来说,主要有如下的几步:
- 提取所有目标框的宽高
遍历训练集,提取到每张图中的每个 Ground Truth 框的宽和高,组成一个数据点,如:$\left(w_i,h_i\right) $。
- 重新定义度量的方法
原始的 K-Means 聚类方法中使用的是欧式距离作为度量的方法,但是在这里,不能直接使用欧式距离作为度量的方法,在目标检测中真正关心的是两个框的重叠程度,也就是 IoU,因此重新定义的度量方法为:
其中,IoU 越大,距离越小;IoU 越小,距离越大。
- K-Means 计算
这个过程就是进行 K-Means 的计算,先初始化 个聚类中心,然后不断迭代和更新,最终得到 个聚类中心:
这就是 YOLO v2 中固定的 anchor 模板,在文献[3]中,聚类中心 的取值为 。
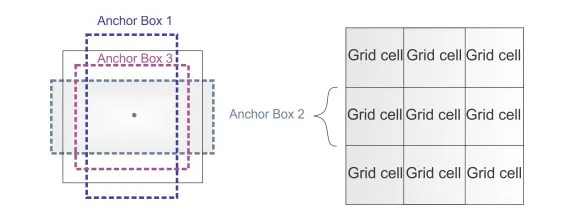
以上得到的 个 anchor 模板还只是在原图上的,还需要将其转换到对应的特征图的尺度上,转换的方法也很简单,如上面,原图是 ,特征图是 的,也就是需要下采样 倍,因此在特征图上的宽高为:
此时在特征图的每一个 cell 上,都会有 个不同宽高的先验框,如下图所示:
3.2. 学习到相对于先验框的偏移量
首先回忆一下,在 Faster R-CNN[2] 中,是根据中心位置来预测偏移值 的。简单来说,假设先验框的宽高为 以及中心坐标为 ,边框的实际中心位置 和实际的宽高为:
训练的时候,我们需要学习到偏移值 。我们注意到,在 Faster R-CNN 中, 控制着中心点向左右偏移, 控制着中心点向上下偏移,且绝对值的大小决定了偏移的幅度。然而, 和 并没有控制范围,可以是任意的数值,这就有可能会导致预测框偏离得很远,甚至于超出图像的外面;也有可能很小,导致难以训练。最好的方法就是对其加以控制,限制其在一定的范围内。
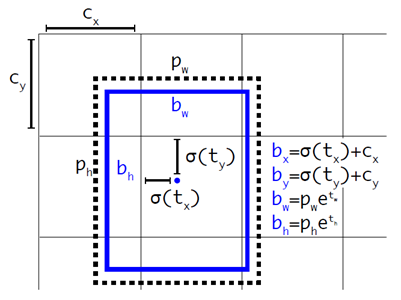
在 YOLO v2 中,对偏移值 和 做了限制,限制其是相对于 cell 左上角位置的相对偏移值。需要预测 4 个偏移值:,可以根据如下的公式计算出实际的边界框的位置和大小:
其中, 为 cell 的左上角在特征图上的坐标, 为 Sigmoid 函数, 和 的输出被控制在 之间。这样,预测框的中心就被限制在当前的 cell 内部,不会偏离很远,如下图所示:
宽高与 Faster R-CNN 中一致,只是延续文献[3],在符号表述上有些不同:
其中, 和 是先验框的宽高。
注意:这里需要注意一点的是,在 Faster R-CNN 中,所有的定义是在原图尺度上;而在 YOLO v2 中,所有的定义是在特征图尺度上,也就是说 和 是在特征图尺度上的宽高。
3.3. 与 Ground Truth 匹配
有了如上的定义之后,就需要学习如何与 Ground Truth 匹配。如上,YOLO v2 中的参数定义的尺度是在特征图上的,因此,首先需要将 Ground Truth 先映射到特征图上,这个与 YOLO v1 中也是一致的。映射完成之后,就看 Ground Truth 的中心落在哪个 cell 中,那么对应的 cell 就负责预测该 Ground Truth,同时,每个 cell 设置了 个 anchor,与 YOLO v1 中一样,选择和 Ground Truth 的 IoU 最大的那个 anchor 作为正样本。其他与 YOLO v1 中一致,更多的 YOLO v1 相关的知识,可以参考[4]。
4. 其他的改进
以上就是 YOLO v2 中最主要的改进,除此之外,还有一些其他的优化:
- 采用了全卷积的架构,去除了全连接层,这样有利于处理不同大小的输入图像;
- 重新设计了网络结构,文中称为 Darknet-19;
- 在卷积层的基础上增加的 Batch Normalization,现在回头来看这些优化,都是在特征层面增强网络的性能。
5. 总结
YOLO v2 在 YOLO v1 的基础上,重点解决 YOLO v1 的两个痛点:定位不够准和召回率偏低。通过引入 Anchor Box,并在 Anchor Box 的基础上,学习基于此的微调,能够极大降低学习的难度;同时,每个 cell 引入了 5 个 Anchor Box,再加上两个语义特征层,可召回的数量极大提升,这也奠定了 YOLO 的基本框架,为后续的优化升级奠定了基础。
参考文献
[1] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.
[2] Ren S, He K, Girshick R, et al. Faster r-cnn: Towards real-time object detection with region proposal networks[J]. Advances in neural information processing systems, 2015, 28.
[3] Redmon J, Farhadi A. YOLO9000: better, faster, stronger[C]//2017 IEEE conference on computer vision and pattern recognition (CVPR). Ieee, 2017: 6517-6525.
[4] 目标检测 YOLO v1 算法